
一、背景:一个月里冒出来的新品类
2026 年 9 月 15 日,TypeSafe 发布了 Jev,并把它叫作「System One 模型」,名字来自卡尼曼《思考,快与慢》里那套快速、凭直觉的「系统 1」。它不写文字,只做一件事:针对给定的输入,回答事先定好选项的问题。
之后的一个月,这个方向热闹得出乎意料。10 月 1 日前后,Cloudflare 开源了 Clef,AWS 开源了 Strands Decider 2B;微软推出了 Microsoft-Decision-1;OpenAI 的 Decisions API 在 10 月 22 日正式开放;Ollama 0.35 开始支持在本地跑这类模型;Base Labs 发布了 mammoth-1 和 elephant-1;阿里云百炼在 9 月 24 日上架了 decision-model-preview,阿里还发了论文 Qwen-Audio-Jev,让决策模型直接「听」音频;高校也接连发论文做独立评测。
本文的核心观点是:决策模型最大的卖点是延迟低、成本低,而这两点恰好也是本地开源模型最擅长的;再加上决策模型通常用在窄领域,用自己的数据训练很容易做到很好,所以这是开源和小团队最有机会追上、甚至超过商业闭源模型的方向。
二、什么是决策模型
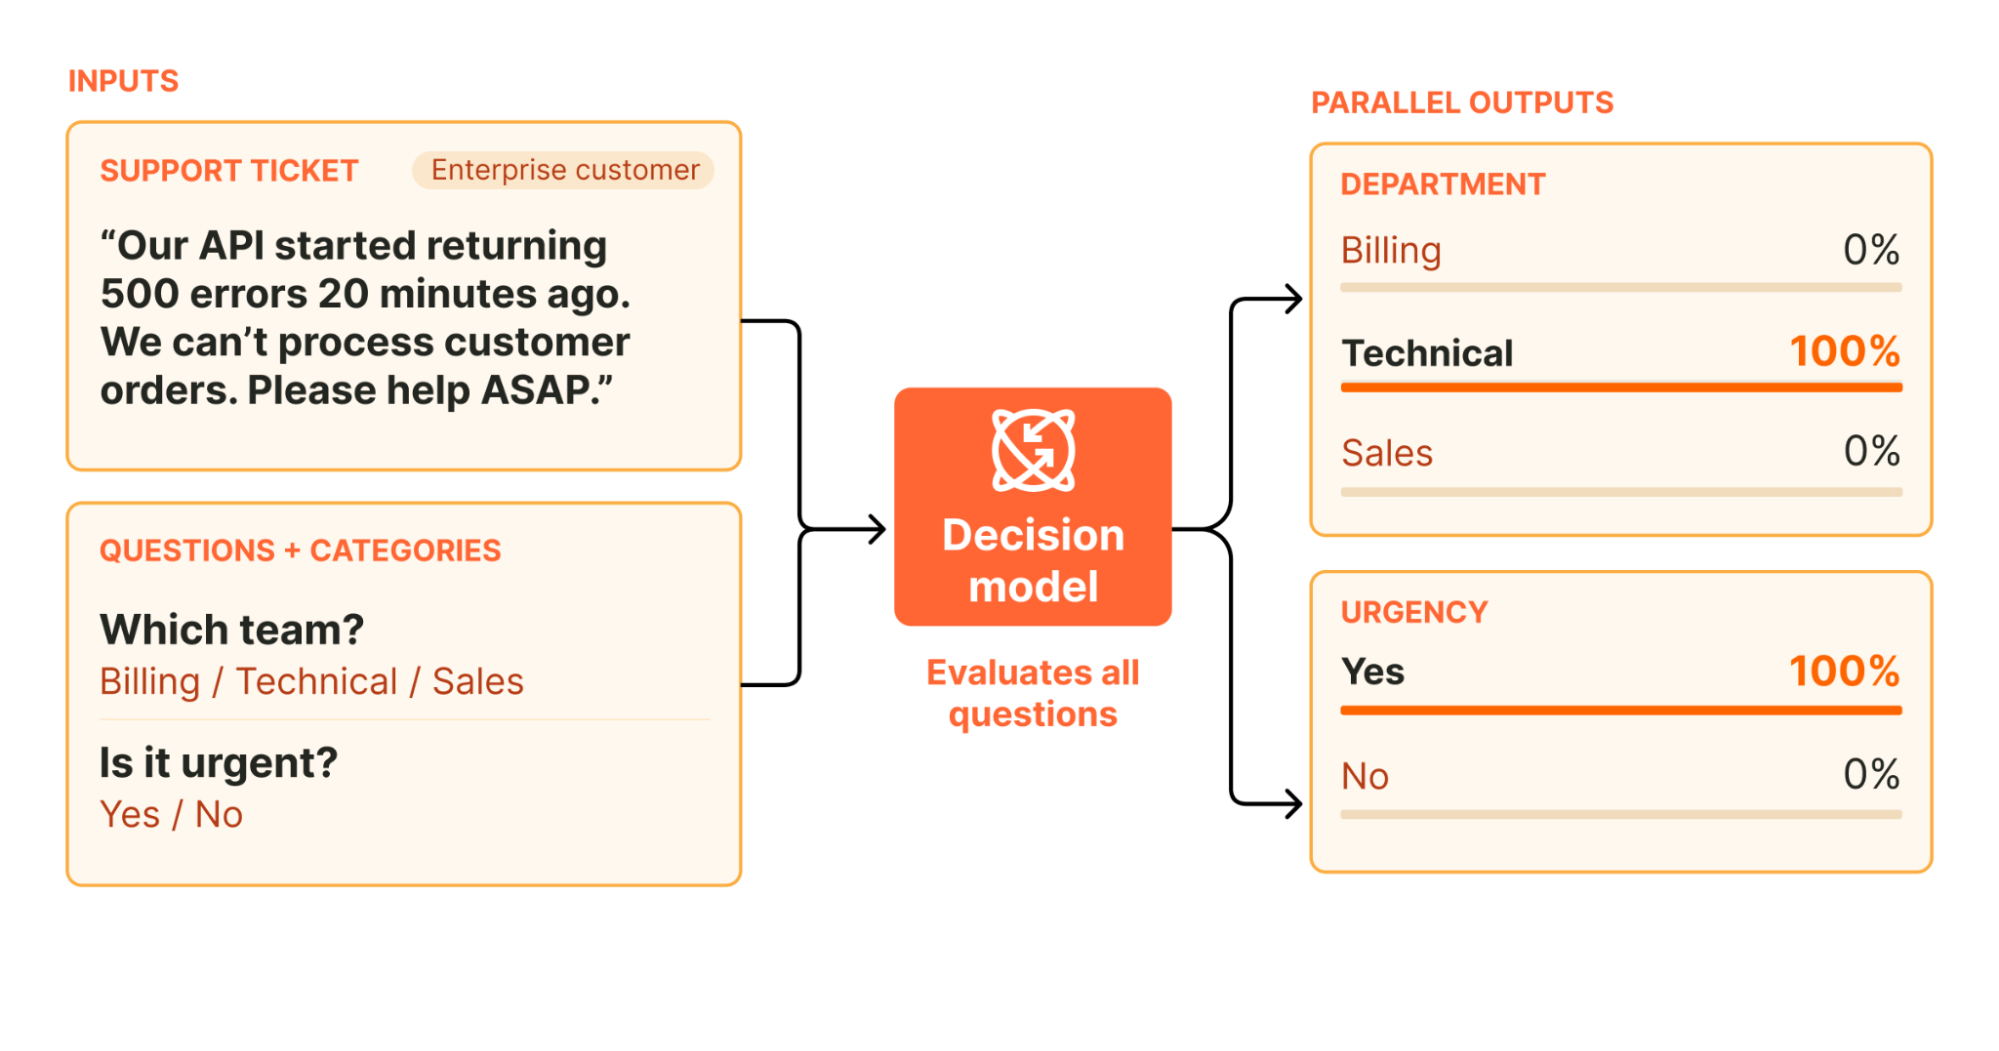
(一)输入和输出
一个请求由两部分组成:一段状态(state),比如一张客服工单、一份 JSON、一段 Agent 的执行记录;以及若干个问题。每个问题只能是三种类型之一:
- 选择(choice):从给定选项里选一个,同时返回每个选项的概率,比如「这张工单该交给哪个团队」。
- 是否(Jev 叫 noul,OpenAI 叫 predicate):返回「是」的概率,比如「这条消息是不是提示词注入」。
- 打分(score):按 2 到 10 个等级打分,返回每个等级的概率和期望等级,比如「客户有多生气」。
(二)为什么快:一次前向,直接读选项概率
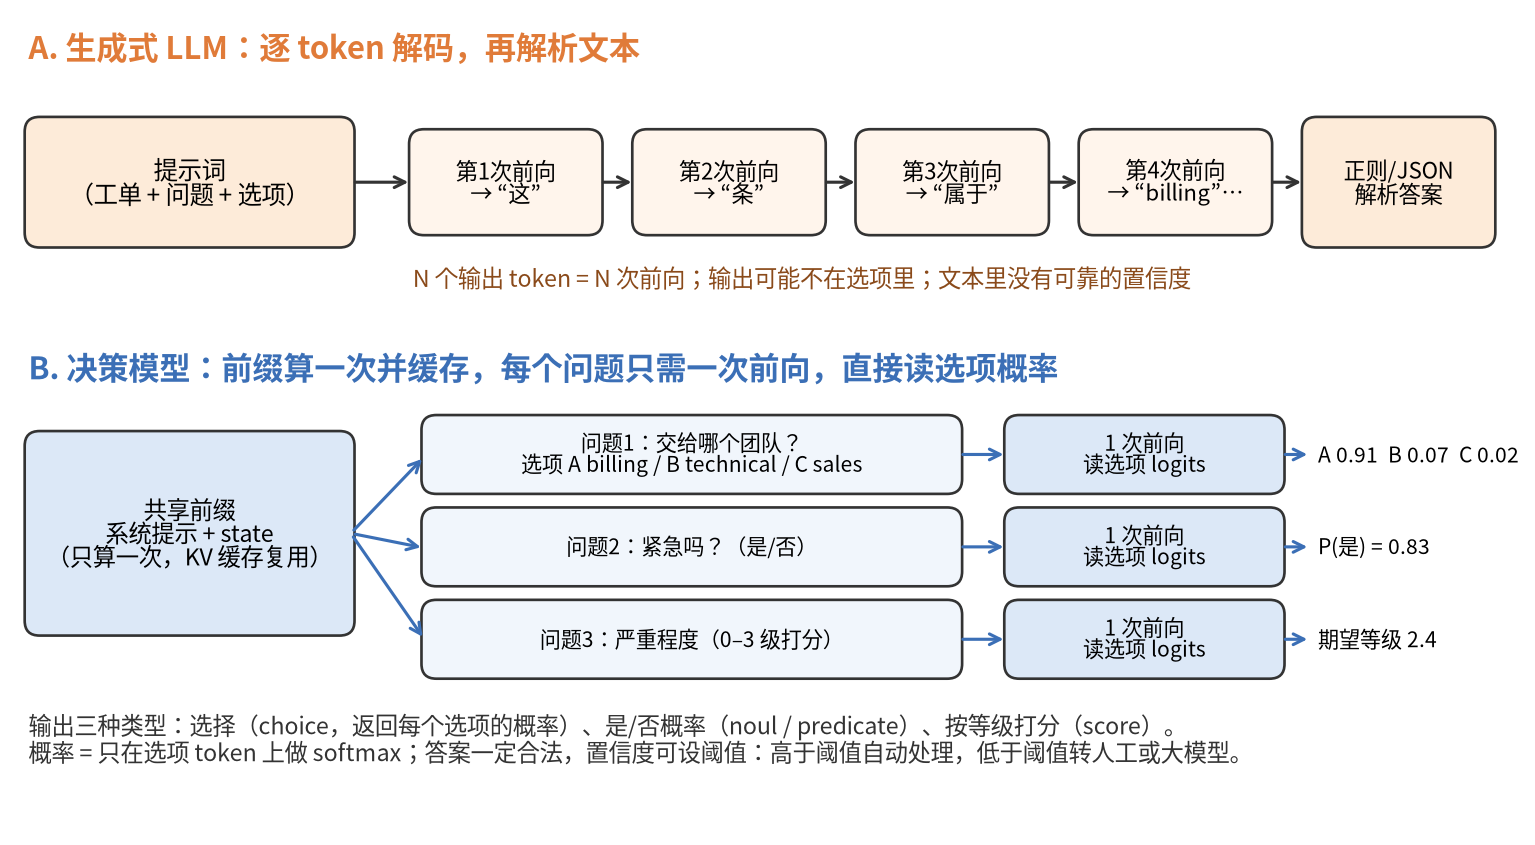
普通大模型做分类,要先把答案一个 token 一个 token 地生成出来,再用正则或 JSON 解析。输出几个 token 就要做几次前向计算,结果还可能不在选项里,而且文本里没有可靠的置信度。
决策模型的做法不一样。以 Base Labs 公开的技术报告为例:系统提示和 state 组成一段共享前缀,只算一次,KV 缓存给后面所有问题复用;每个问题的说明和选项作为后缀,在答案位置上做一次前向计算,然后只在选项字母对应的 logits 上做 softmax,得到每个选项的概率。所以:
- 快:没有逐字生成,加一个问题只多算一段后缀。OpenAI 的 Decisions API 一次请求最多可以问 400 个问题。
- 便宜:只收输入费,输出免费。Jev 每百万输入 token 0.042 美元,Decisions API 0.10 美元(缓存命中 0.01 美元)。
- 格式不会错:答案一定是给定的选项之一。
- 有置信度:可以设阈值,高于阈值就自动处理,低于阈值转给人工或大模型。
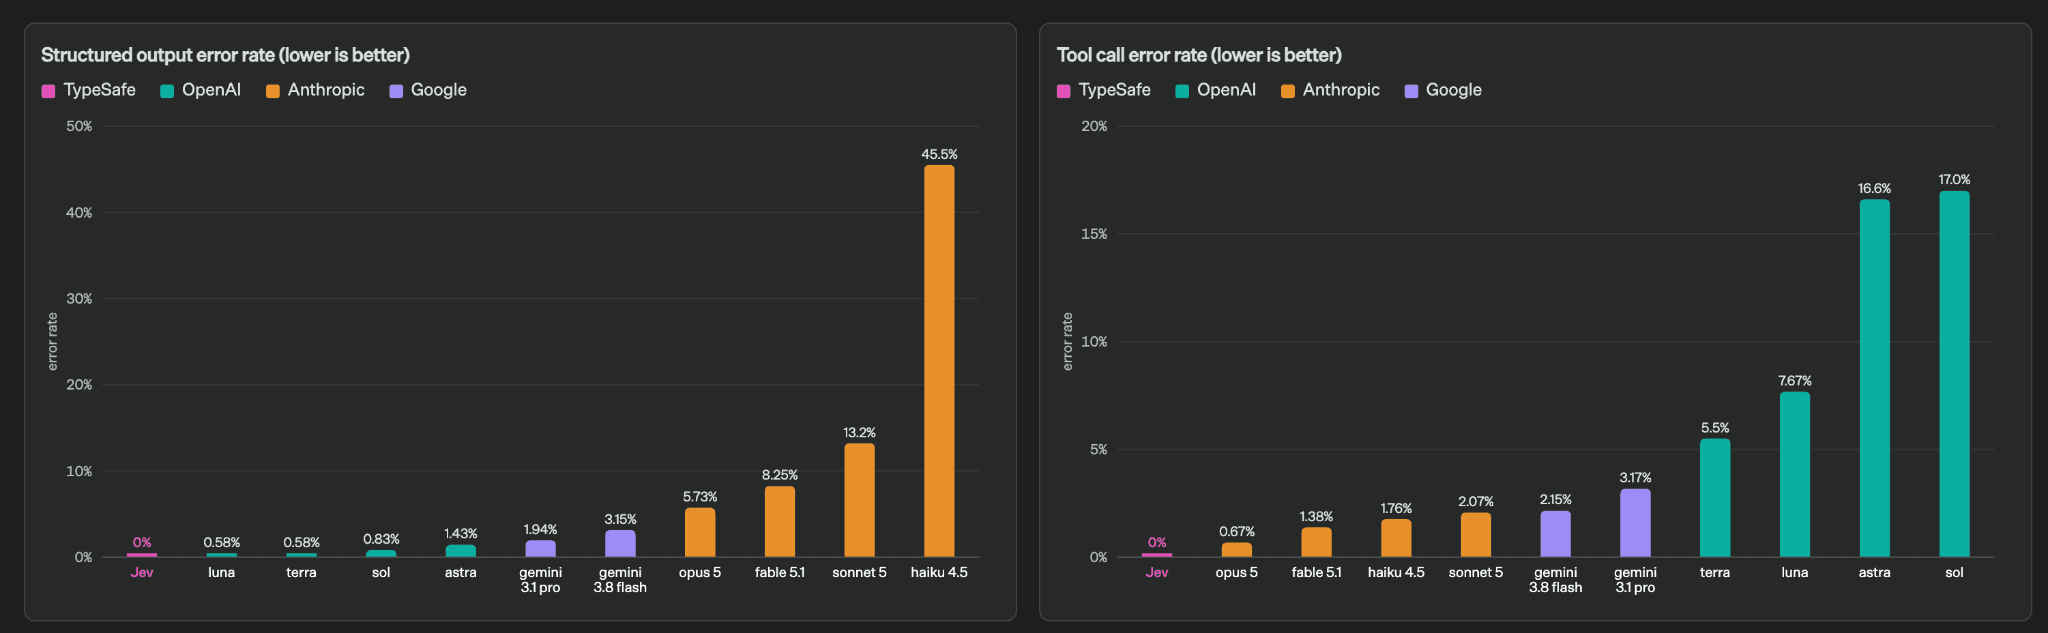
图源:TypeSafe 官方博客《Introducing System One models & Jev》(厂商自报)
置信度这一点很实用。波恩大学的独立评测显示,Jev 在 BANKING77 上整体准确率 79.7%,但只保留它最有把握的一半答案时,准确率升到 96.3%。
(三)主要产品一览
| 模型 | 发布方 | 是否开放权重 | 参数量 | 价格 / 部署 | 备注 |
|---|---|---|---|---|---|
| Jev | TypeSafe | 闭源 API | 未公开 | 每百万输入 token $0.042 | 上下文 32K,只支持文本 |
| Decisions API | OpenAI | 闭源 API | 未公开,基于 GPT‑6 Luna | 每百万输入 token $0.10 | 支持文本、图片、原生 JSON |
| Microsoft-Decision-1 | 微软 | 闭源 API | 9B(Qwen3.5-9B 底座) | 每百万输入 token $0.042 | 上下文 32K,只支持文本 |
| SubQ Snap 1.1 | Subquadratic | 闭源 API(公开预览) | 未公开 | 每百万输入 token $0.04 | 上下文 384K,支持图片 |
| Clef / Clef-flash | Cloudflare | 开放,Apache 2.0 | 27B / 9B | 托管在 Workers AI,也可本地跑 | 上下文 64K,带视觉编码器 |
| mammoth-1 / elephant-1 | Base Labs | 开放 | 27B / 9B | 自部署 | 自报 Jev Decision Index 第一 |
| Nimble | Bespoke Labs | 开放,Apache 2.0 | 9B | ollama pull nimble | 基于 Qwen3.5-9B |
| Strands Decider | AWS Strands Labs | 开放,Apache 2.0 | 2B | 本地 CPU/GPU | 公开了训练数据和脚本 |
| tev1 | Together AI | 开放(实验性) | 4B / 0.8B | Ollama | |
| decision-model-preview | 阿里云百炼(QwenCloud) | 闭源 API | 未公开 | 限时免费 | 上下文 64K,只支持文本,兼容 System One 协议 |
| Qwen-Audio-Jev | 阿里(Token Foundry) | 论文,未开放权重 | 未公开(MoE 底座) | 研究阶段 | 输入音频,基于 Qwen-Audio-3.1-ASR-Flash-Next |
阿里 / Qwen 也下场了。 目前能查到两款:
- decision-model-preview:9 月 24 日上架阿里云百炼(国际版 QwenCloud 同步),闭源托管 API,只支持文本,上下文 64K,目前限时免费,参数量没公开。它直接沿用 TypeSafe 的 System One 协议(
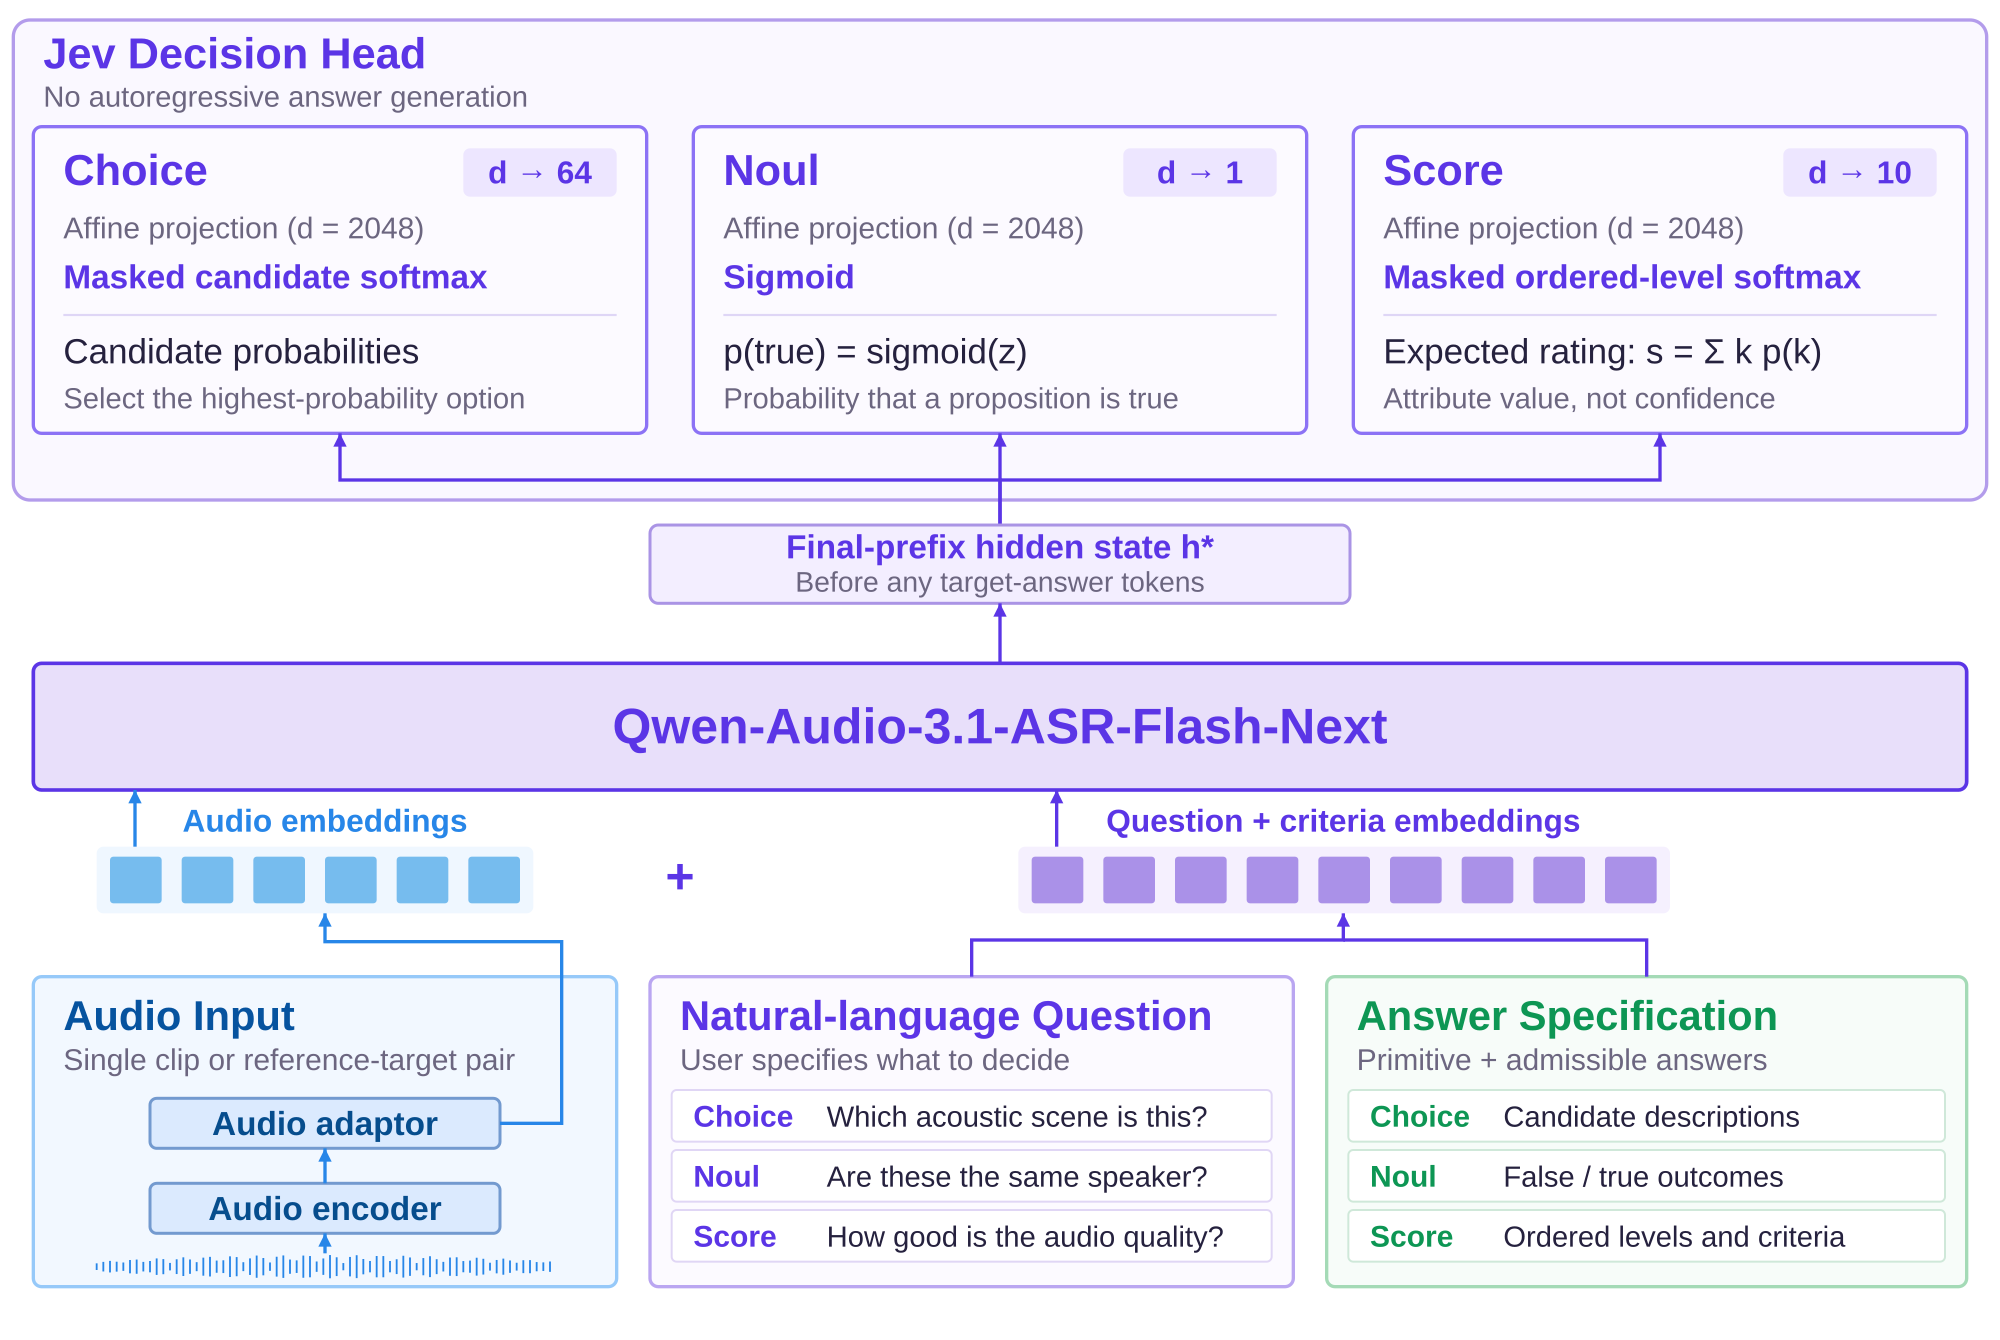
/compatible-mode/v1/systemone),官方示例就是用typesafe-sdk换个 base_url 调用;一次最多 16 个问题,官方说明延迟随问题数近线性增长。对国内开发者来说,这是现在不用跨境、在北京地域就能直接调的决策 API。 - Qwen-Audio-Jev:阿里 Token Foundry 10 月 15 日发在 arXiv 的论文(10 月 22 日更新到 v2),在语音模型 Qwen-Audio-3.1-ASR-Flash-Next 上加了一个 Jev 风格的决策头,输入是音频,输出 Choice / Noul / Score 三种决策,用来做声音场景分类、说话人验证、音质打分这类任务。v2 自报结果:MMAU 78.40%,MMSU 83.14%,VoxCeleb1-O 说话人验证准确率 93.76%,NISQA 整体音质归一化 MAE 0.1235。v1 摘要里写了「比原模型推理快约 20 倍」,但 v2 摘要删掉了这句,正文也没有给出测速数据,所以这个数字先别引用。它目前没有开放权重,论文说之后计划发一个更轻量的版本。
三、核心优势:延迟和成本,正是本地开源模型的主场
决策模型存在的理由,就是把 Agent 和业务流程里大量「小判断」从昂贵、缓慢的大模型调用里拆出来。
Fractional Research 汇总了四位独立测试者 9 月下旬的结果:Jev 的延迟中位数在 0.24 到 0.39 秒之间;和同样为决策场景配置好的普通大模型相比,Jev 只快 2.0 到 3.6 倍,但每次决策便宜 5 到 50 倍。厂商宣传里的「快 193.6 倍」是拿慢配置的大模型做对比得出的,实际用不上。
所以,延迟和成本再往下压,瓶颈就不在模型本身,而在网络和计费方式。这正是本地开源模型的强项。
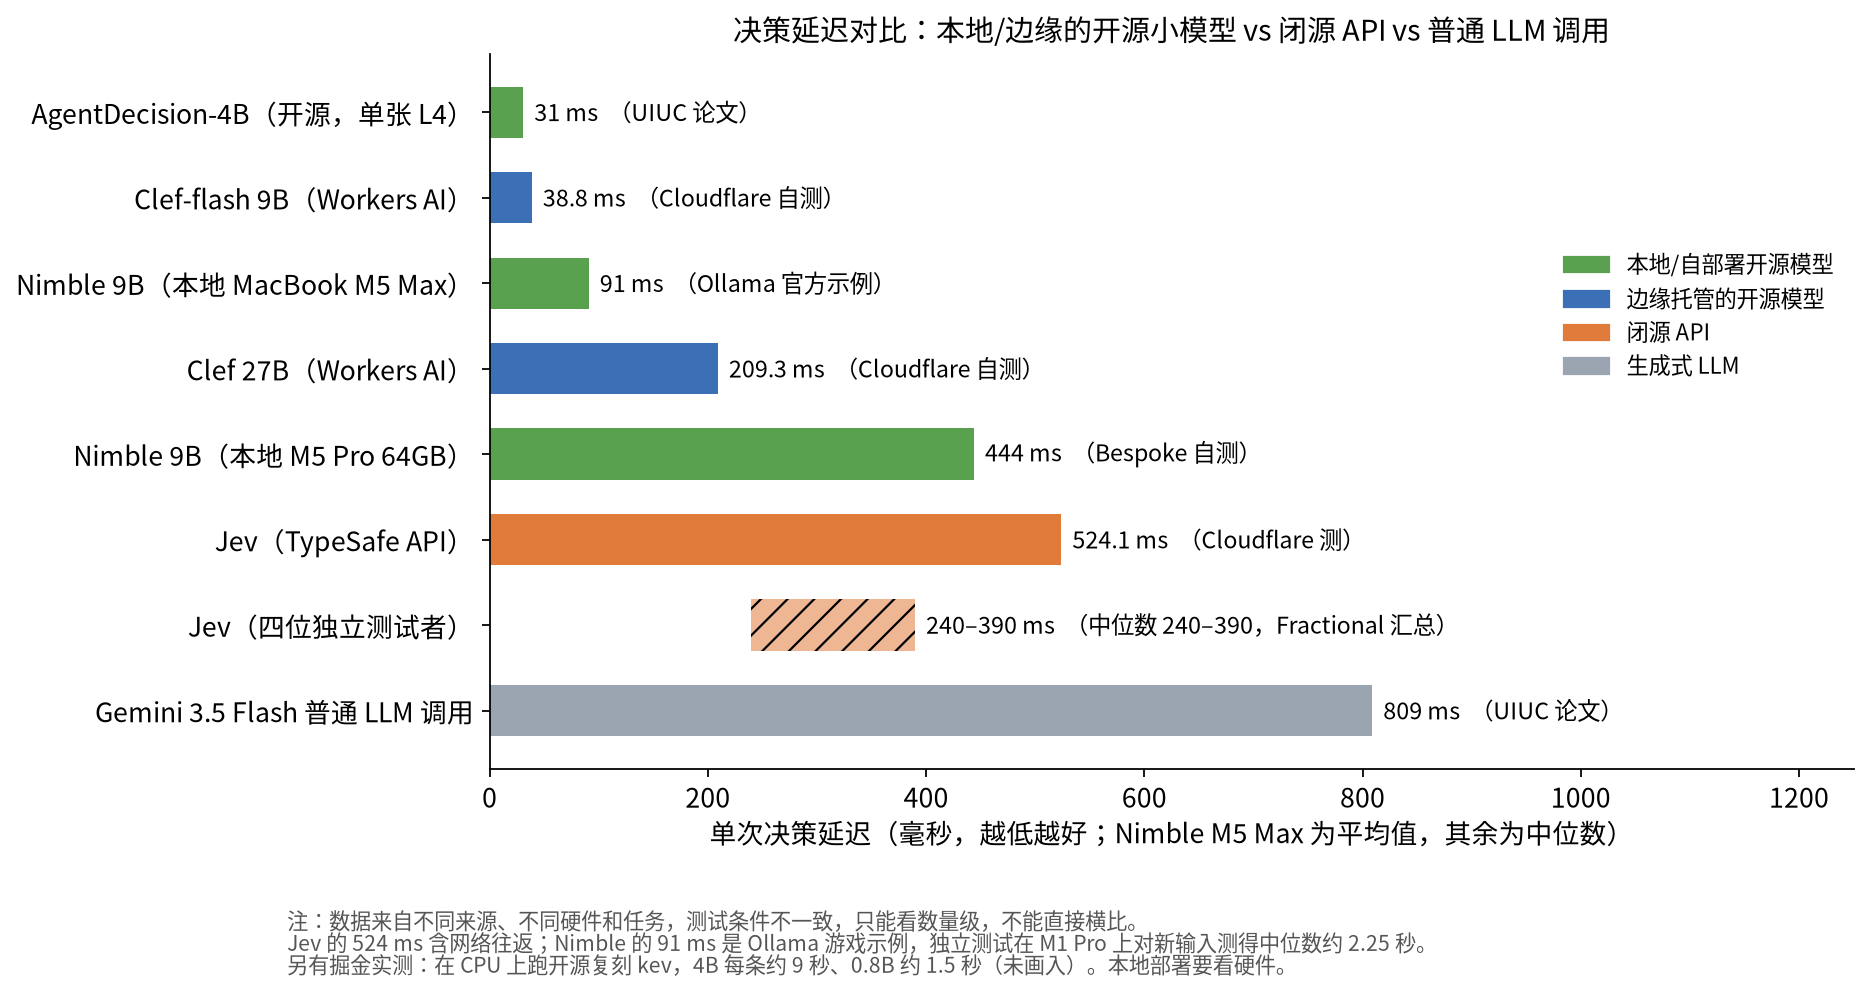
几类部署方式的数据对比如下:
- 闭源 API:独立测试的中位数是 240 到 390 毫秒,Cloudflare 测得 524.1 毫秒,都含网络往返。
- 边缘托管的开源模型:Cloudflare 自测 Clef-flash 中位数 38.8 毫秒,Clef 209.3 毫秒。Cloudflare 自己也说,部分优势来自模型部署在离用户近的边缘 GPU 上。
- 本地自部署:UIUC 的 AgentDecision-4B 在一张 L4 上中位数 31 毫秒,而同一实验里一次 Gemini 3.5 Flash 调用要 809 毫秒。Ollama 官方示例里,Nimble 9B 在 M5 Max 笔记本上平均每次决策 91 毫秒。
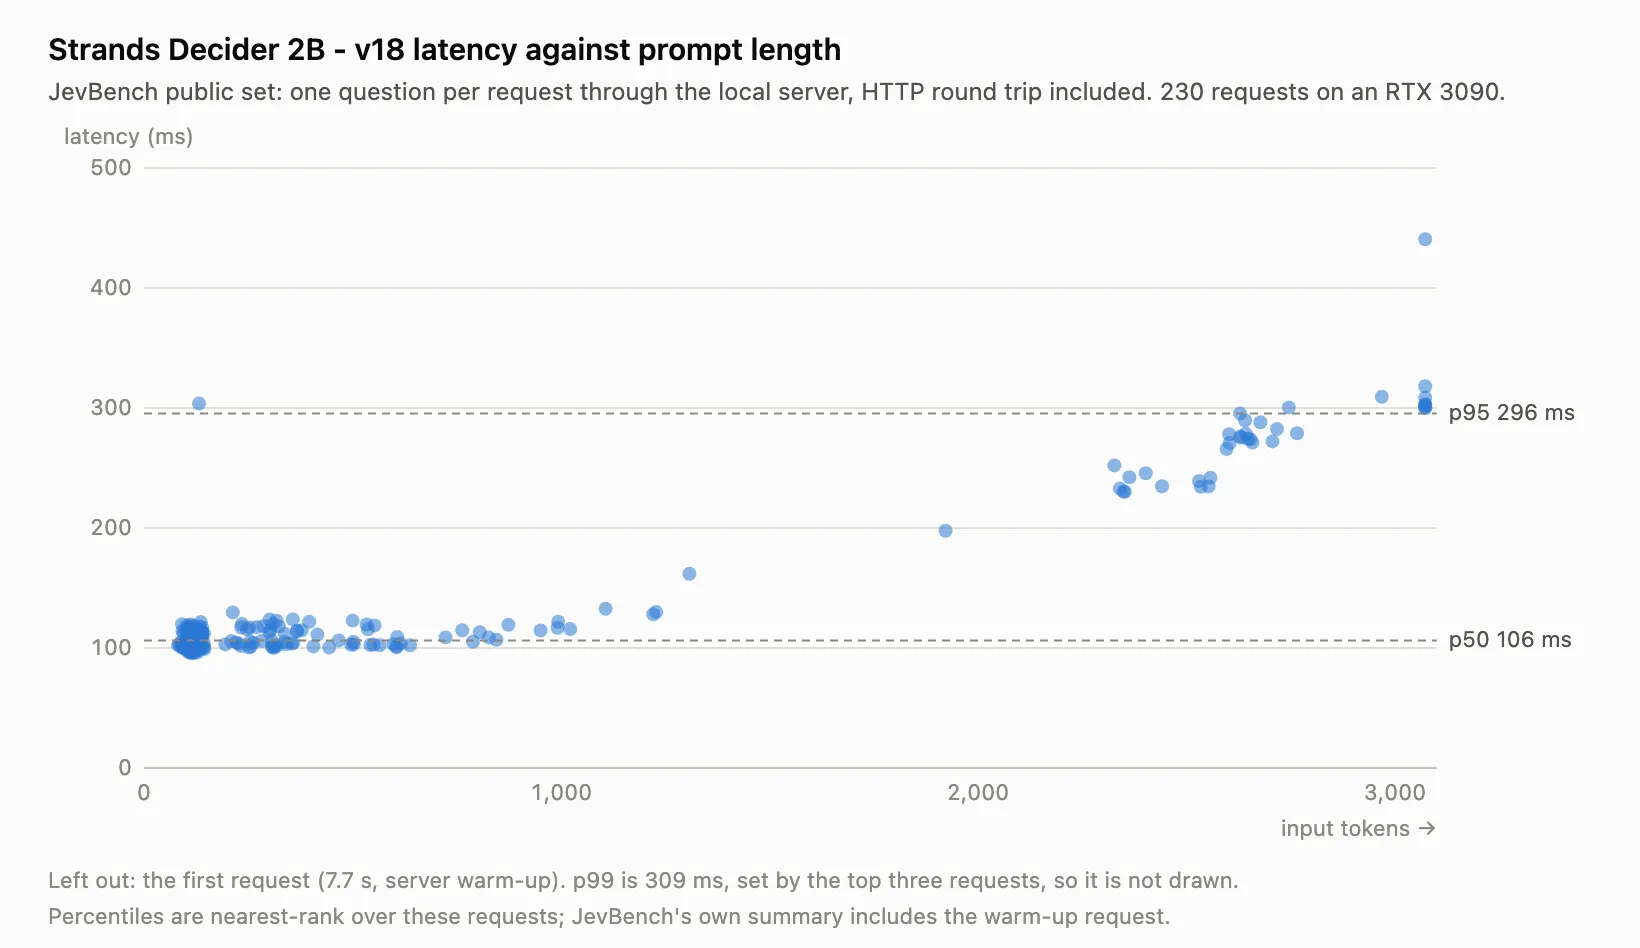
图源:Strands Agents 官方博客《Introducing Strands Decider 2B》(官方自测)
Hamel Husain 在测评里也专门提醒:延迟很大程度上取决于怎么做批处理和并发、和厂商的合作方式,以及与服务器之间的距离,模型本身只是其中一部分。
成本也一样。Overmind 的实验里,在一张 L40S 上跑微调过的 4B 模型,每千次调用的服务成本约 0.014 美元,同一任务调 Jev 约 0.071 美元(前者是 GPU 满载时的下限估计)。
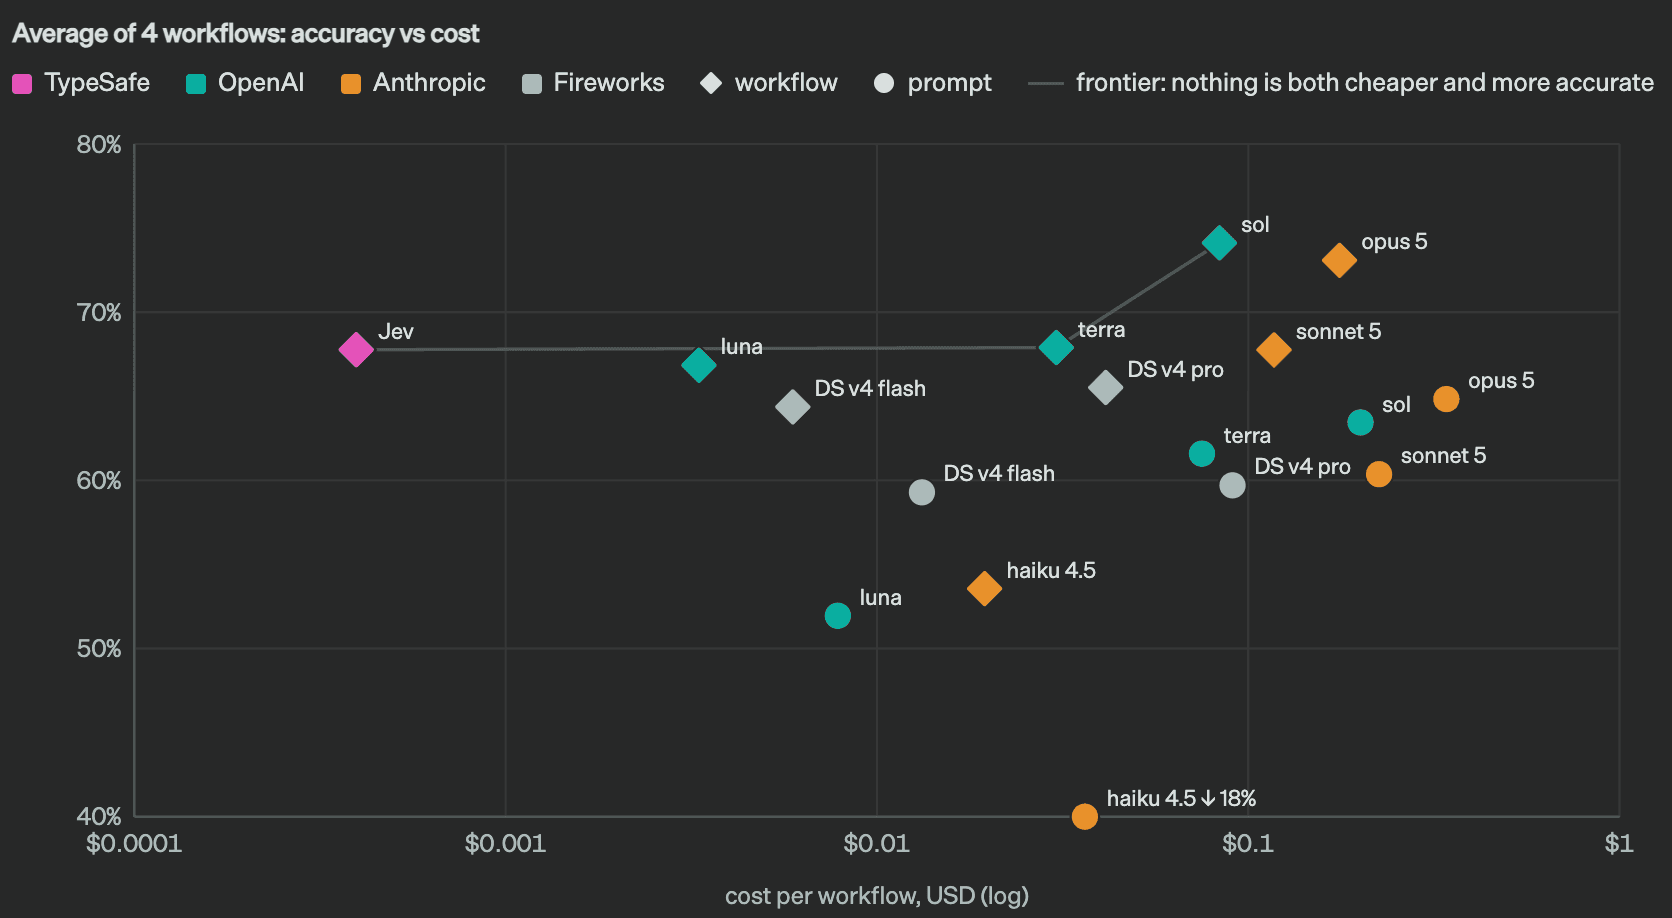
图源:TypeSafe 官方博客《Introducing System One models & Jev》(厂商自报,对比对象是 TypeSafe 自己挑的配置)
对国内开发者而言还有一层因素:OpenAI 的 API 不对中国大陆提供服务,调用海外的闭源决策 API 本来就要多走一段跨境网络。决策模型存在的意义就是快,如果一次决策有一大半时间花在网络上,那把模型放到自己机房里,收益会非常直接。
我的观点:只要硬件到位,决策模型的两个核心卖点在本地部署时会被进一步放大;而大模型时代闭源 API 最核心的优势,也就是「模型能力强到你自己做不出来」,在这里恰恰最弱。
四、窄领域:用自己的数据训练很容易做好
(一)通用决策模型在不少具体任务上并不高
客观地看,Jev 这类通用决策模型零样本的能力很强。波恩大学用 37 个公开数据集独立评测,Jev 在 IMDB、SST-2 等情感二分类上准确率 96% 以上,在 37 个数据集中有 27 个超过了 Qwen3.8-27B。
但在具体业务常见的细粒度任务上,分数明显偏低(同一篇论文的零样本结果):
- BANKING77(77 类银行客服意图):79.7%
- Emotion(6 类情绪):58.5%
- SST-5(5 级情感):57.9%
- Financial PhraseBank(金融新闻情感):73.0%
- AGB-DE(判断德国消费合同条款是否无效):F1 只有 0.204
论文的总结是:标签细、标签有噪声、需要领域知识的任务,以及低资源语言,是这类模型的明显短板。而真实业务里的决策,恰恰大多是这种细分类。
(二)用自己的数据训练一下,小模型就能反超
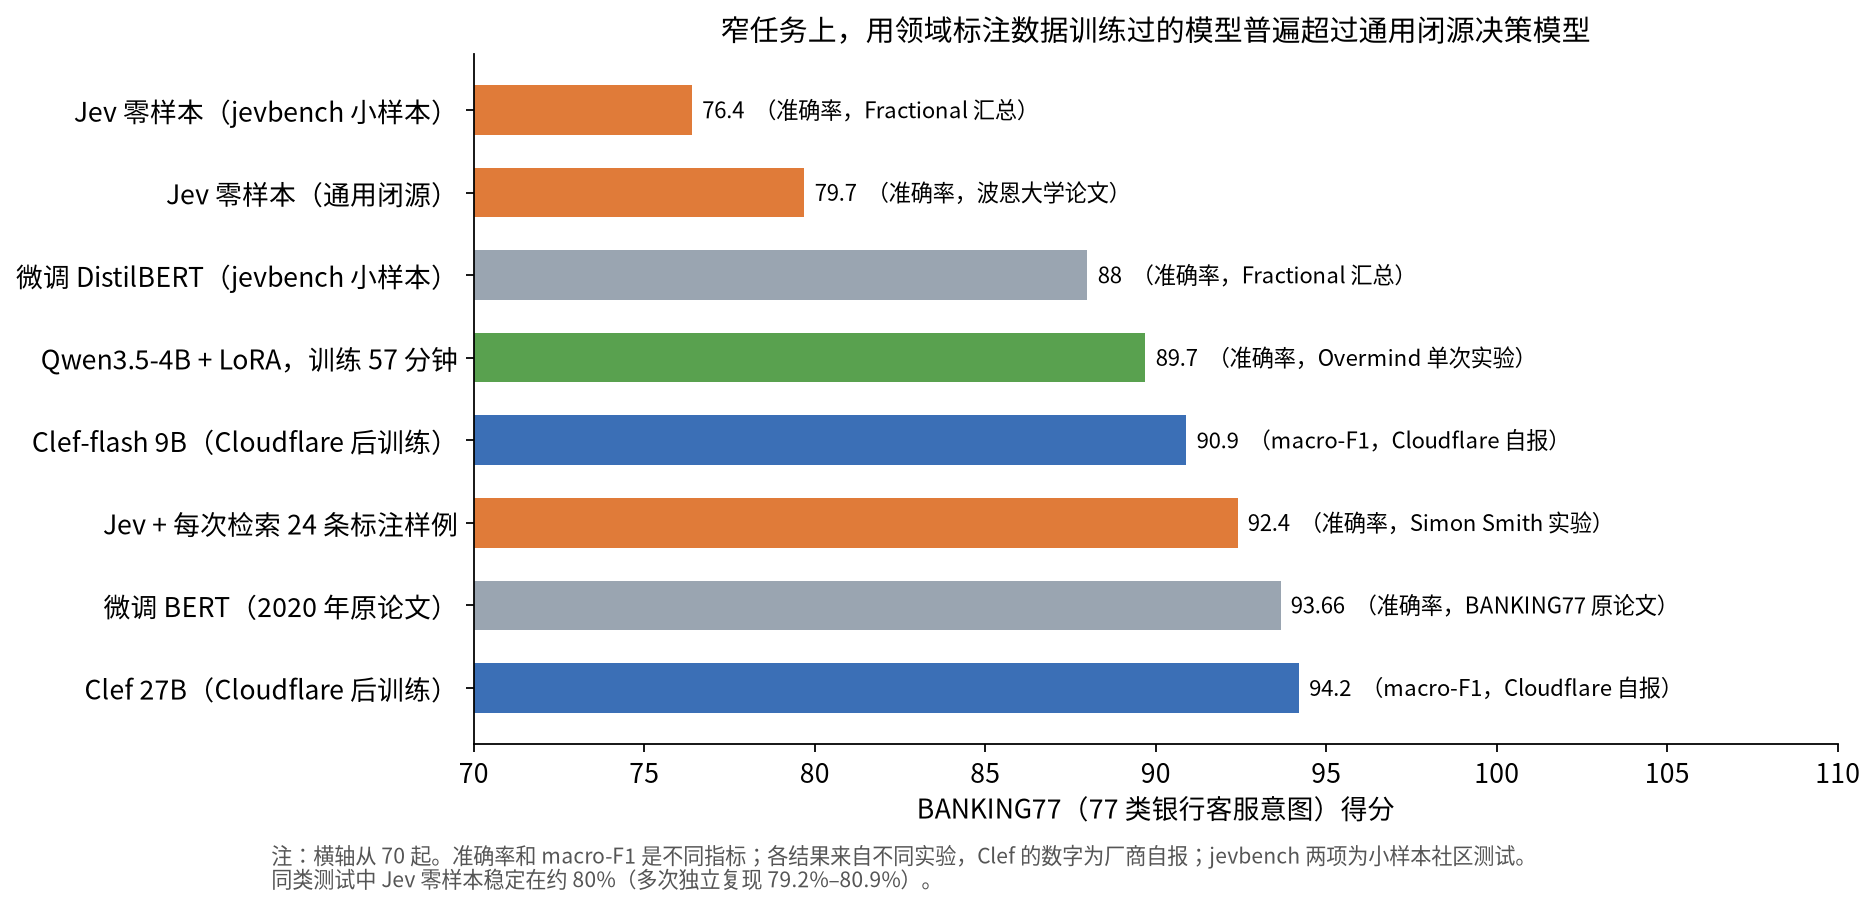
以 BANKING77 为例:
- 社区基准 jevbench 的小样本测试里,微调过的 DistilBERT 准确率 88.0%,Jev 只有 76.4%(Fractional Research 汇总)。
- Overmind 用 Qwen3.5-4B 加 LoRA,在约 1 万条公开训练数据上训练了 57 分钟,没有调参,准确率 89.7%,比 Jev 少了 47% 的错误。
- Cloudflare 在自家基于 Qwen 后训练的 Clef-flash(9B)和 Clef(27B)上,自报 macro-F1 分别是 90.9 和 94.2。
- 2020 年 BANKING77 原论文里,微调过的 BERT 就已经有 93.66%。
在 Agent 场景里也是一样。UIUC 的论文让 4B 模型在 Agent 自己实际经历的状态上训练(训练只花了 2.2 个 GPU 小时),在没见过的任务上,用它做工具选择时任务解决率 91.5%,用 Jev 是 82.0%。门槛也很低:Unsloth 已经有现成教程,把 Qwen3.5-0.8B 训成决策模型只需要 4GB 显存、42 分钟。
(三)但要把结论收窄
不能只看有利的数据。在通用任务上,几家头部决策模型其实拉不开差距。Braintrust 用 WildGuardTest 测有害回答识别,Jev 的 F2 是 82.5%,mammoth-1 是 81.5%,Clef 是 77.9%,统计上分不出高下。Hamel Husain 的测评还提醒,很多人直接用默认的 0.5 阈值,不检查它适不适合自己的任务,这会白白损失不少效果,一定要在自己的数据上调阈值。
更准确的说法是:在自己的窄任务上,用自己的数据加微调,往往能赢;没有数据的时候,通用模型是很好的起点。
五、小参数量:开源闭源都一样
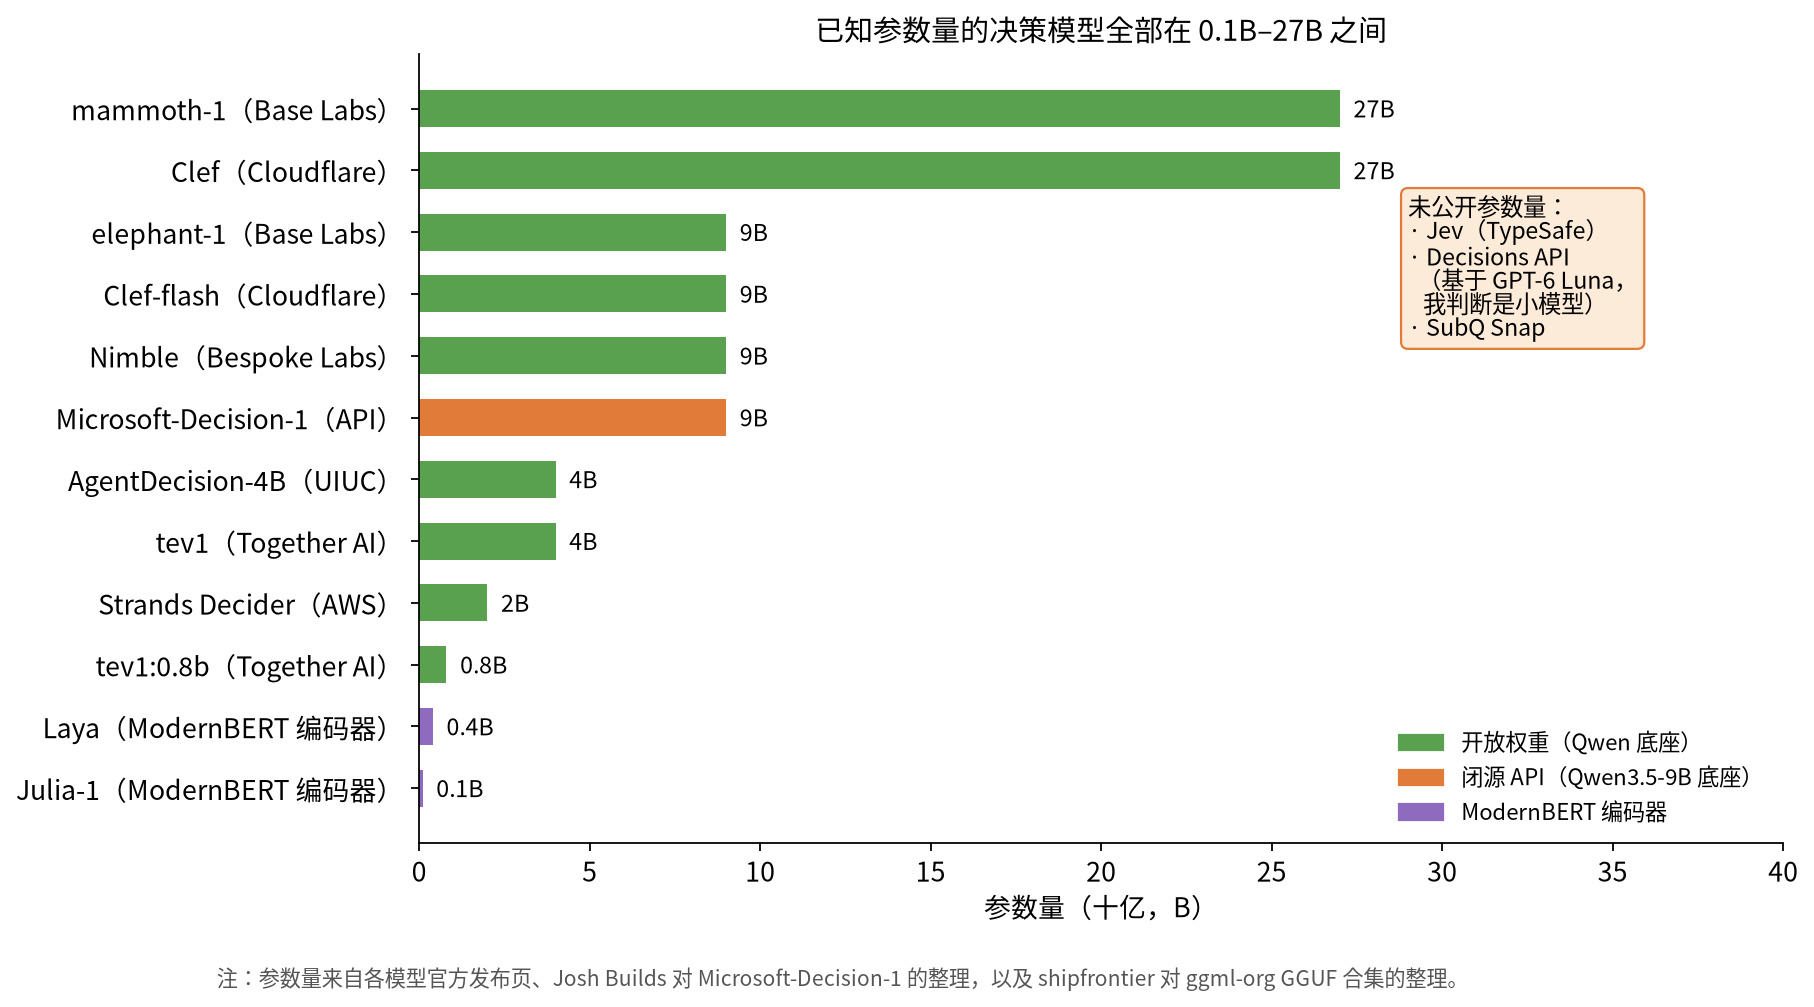
目前已知参数量的决策模型,全部在 0.1B 到 27B 之间:mammoth-1 和 Clef 是 27B,elephant-1、Clef-flash、Nimble 是 9B,AgentDecision 和 tev1 是 4B,Strands Decider 是 2B,tev1 最小版只有 0.8B。ggml-org 发布的决策模型 GGUF 合集里,最小的 Julia-1(0.1B)和 Laya(0.4B)甚至就是 ModernBERT 编码器。
闭源这边没有公开参数量。OpenAI 的 Decisions API 是基于 GPT‑6 Luna 做的,而不是旗舰模型 GPT‑6.1 Sol 或 GPT‑6 Astra。Luna 的参数没有公开,但从它的定位和速度看,我判断它是小模型:Fractional Research 把它归为 OpenAI「便宜的生成式档位」,OpenAI 官方给 Decisions API 的卖点也是「比通过 Responses API 调用 GPT‑6 Luna 最多快 10 倍」。Jev 官方没透露规模,第三方通过大量 API 调用做的黑盒探测,推测它是激活参数在几十亿量级的模型。
六、决策模型很难像大模型那样一直 scaling
首先需要明确的是:在一定范围内,加大参数能提升效果,这一点没有争议。比如同样的训练数据,Base Labs 的 27B mammoth-1 在 Jev Decision Index 上得 71.24 分,9B 的 elephant-1 得 62.65 分,差了 8.6 分。
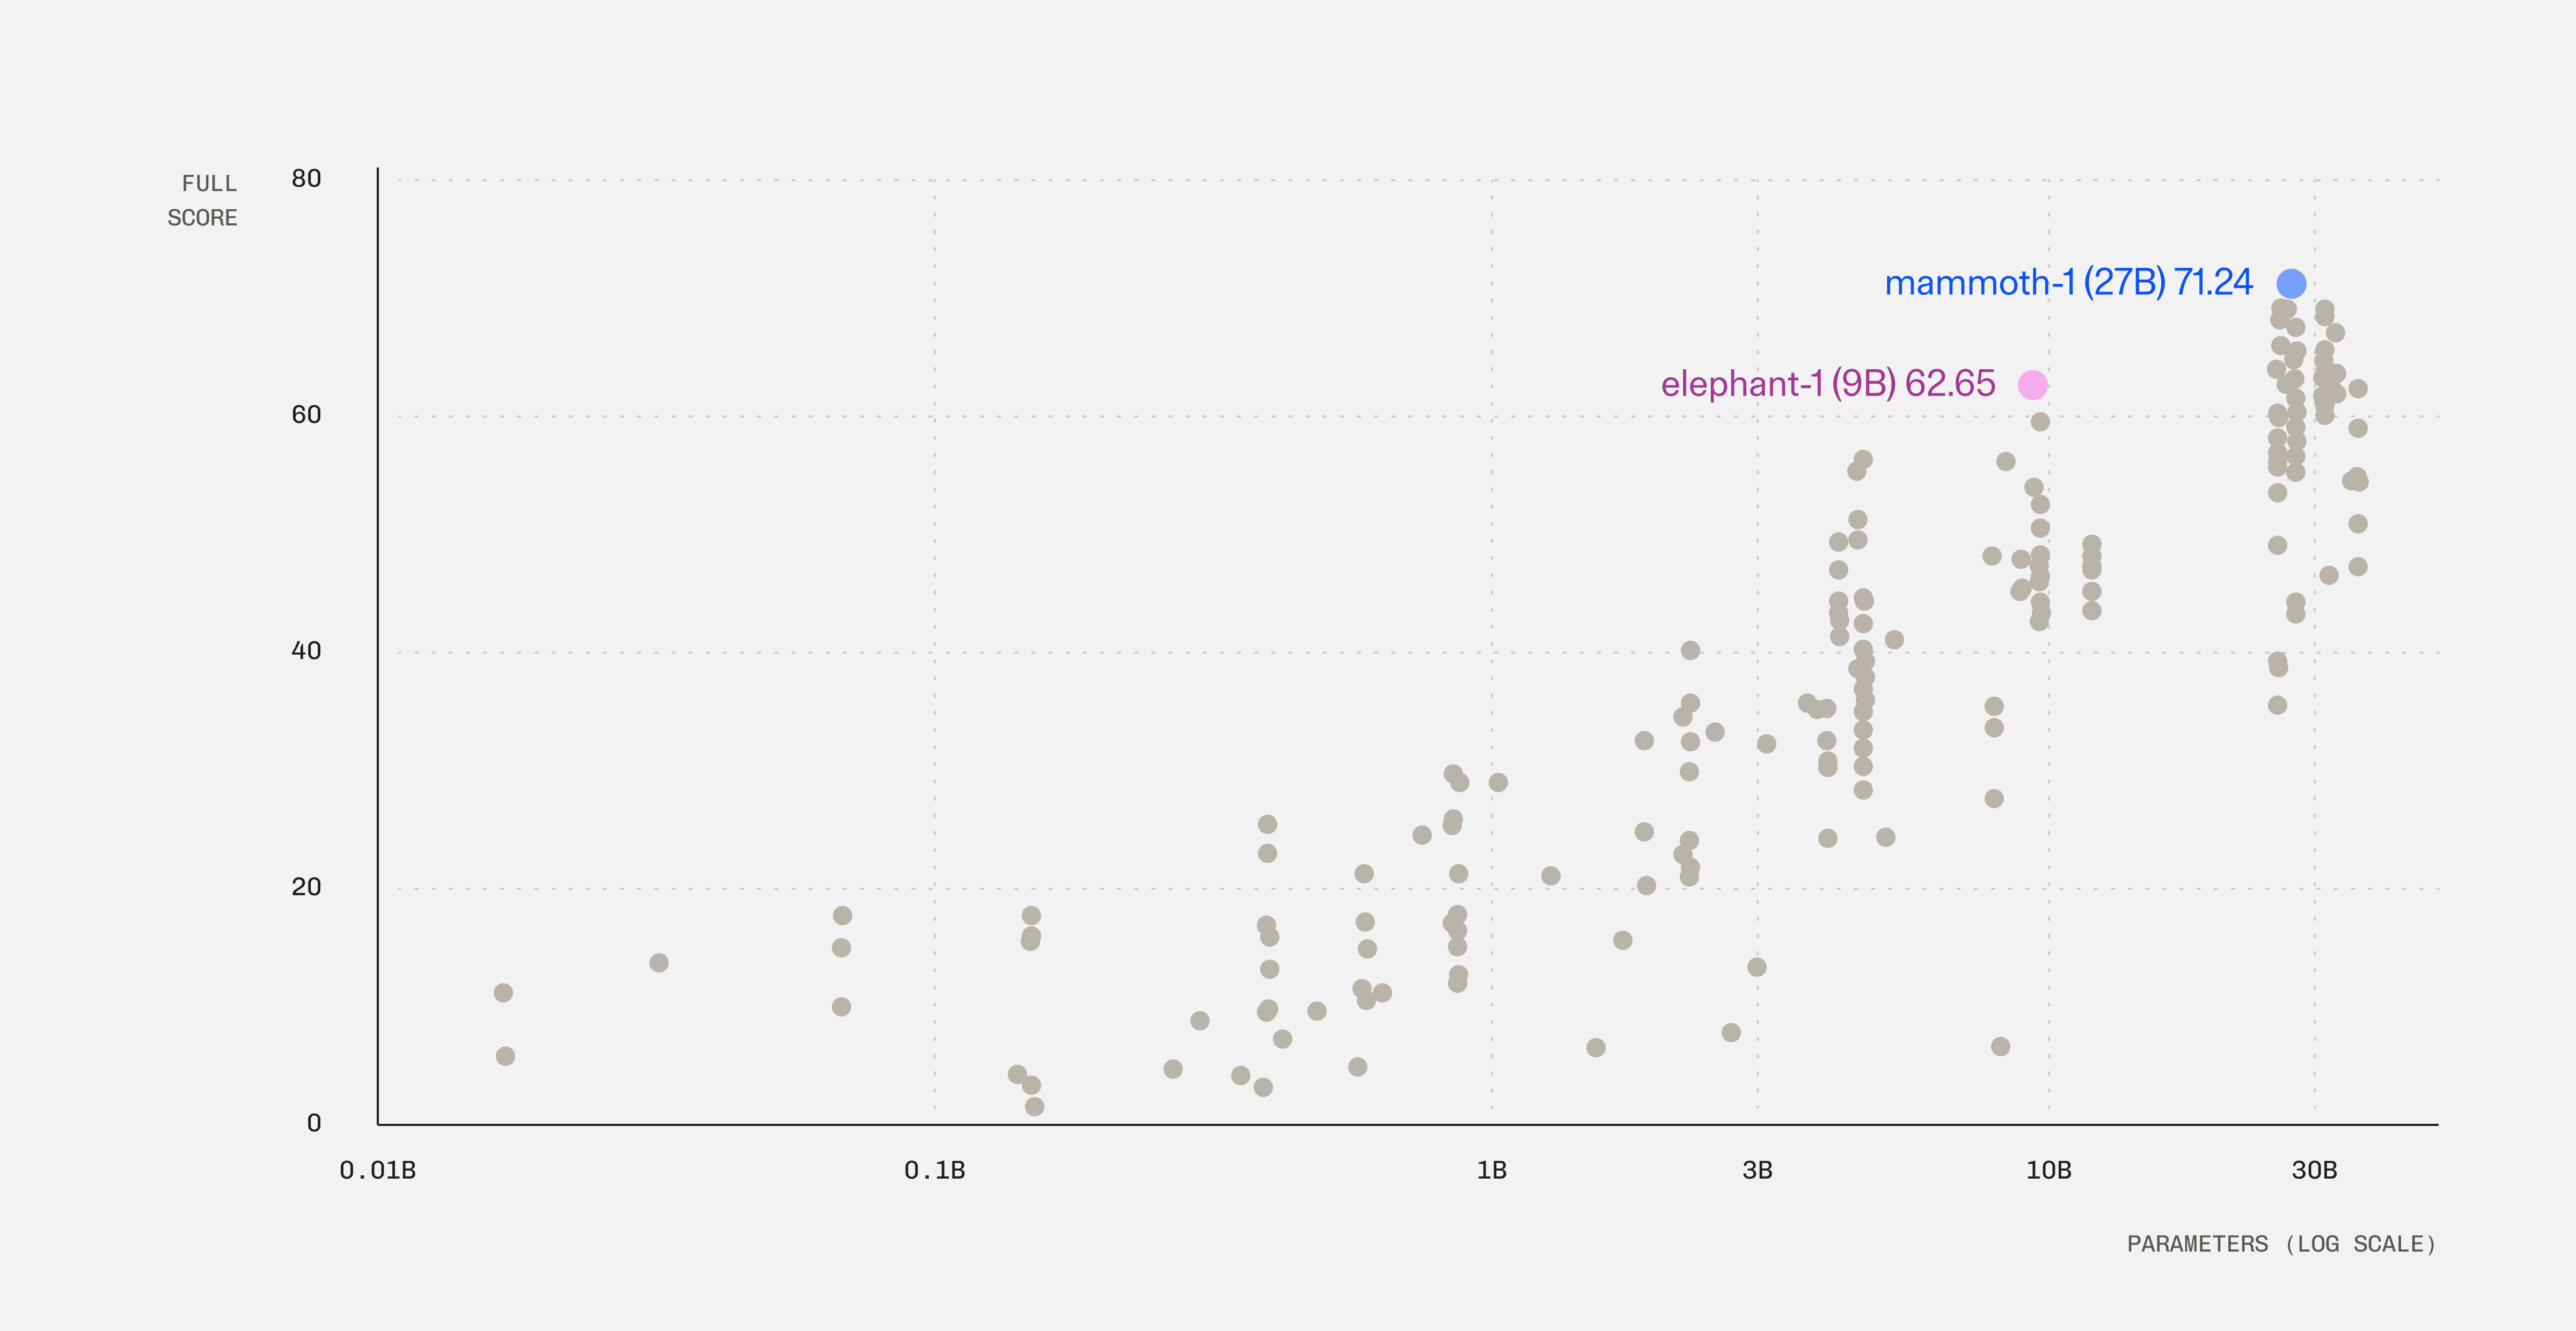
图源:Base Labs 官方技术报告《Mammoth-1 and Elephant-1》(自报)
这里说的「scaling law 还没被认可」,指的是决策模型能不能像大语言模型那样一直往上堆。我认为很难,原因有两个:
- 参数大到一定程度,会和决策模型存在的理由冲突。决策模型的价值就是延迟低、成本低。模型越大,每次决策越慢、越贵,最后就失去了把小判断从大模型里拆出来的意义。前文的数据也显示,同一家的 27B 版本延迟是 9B 版本的五倍多(Clef 209.3 毫秒,Clef-flash 38.8 毫秒)。
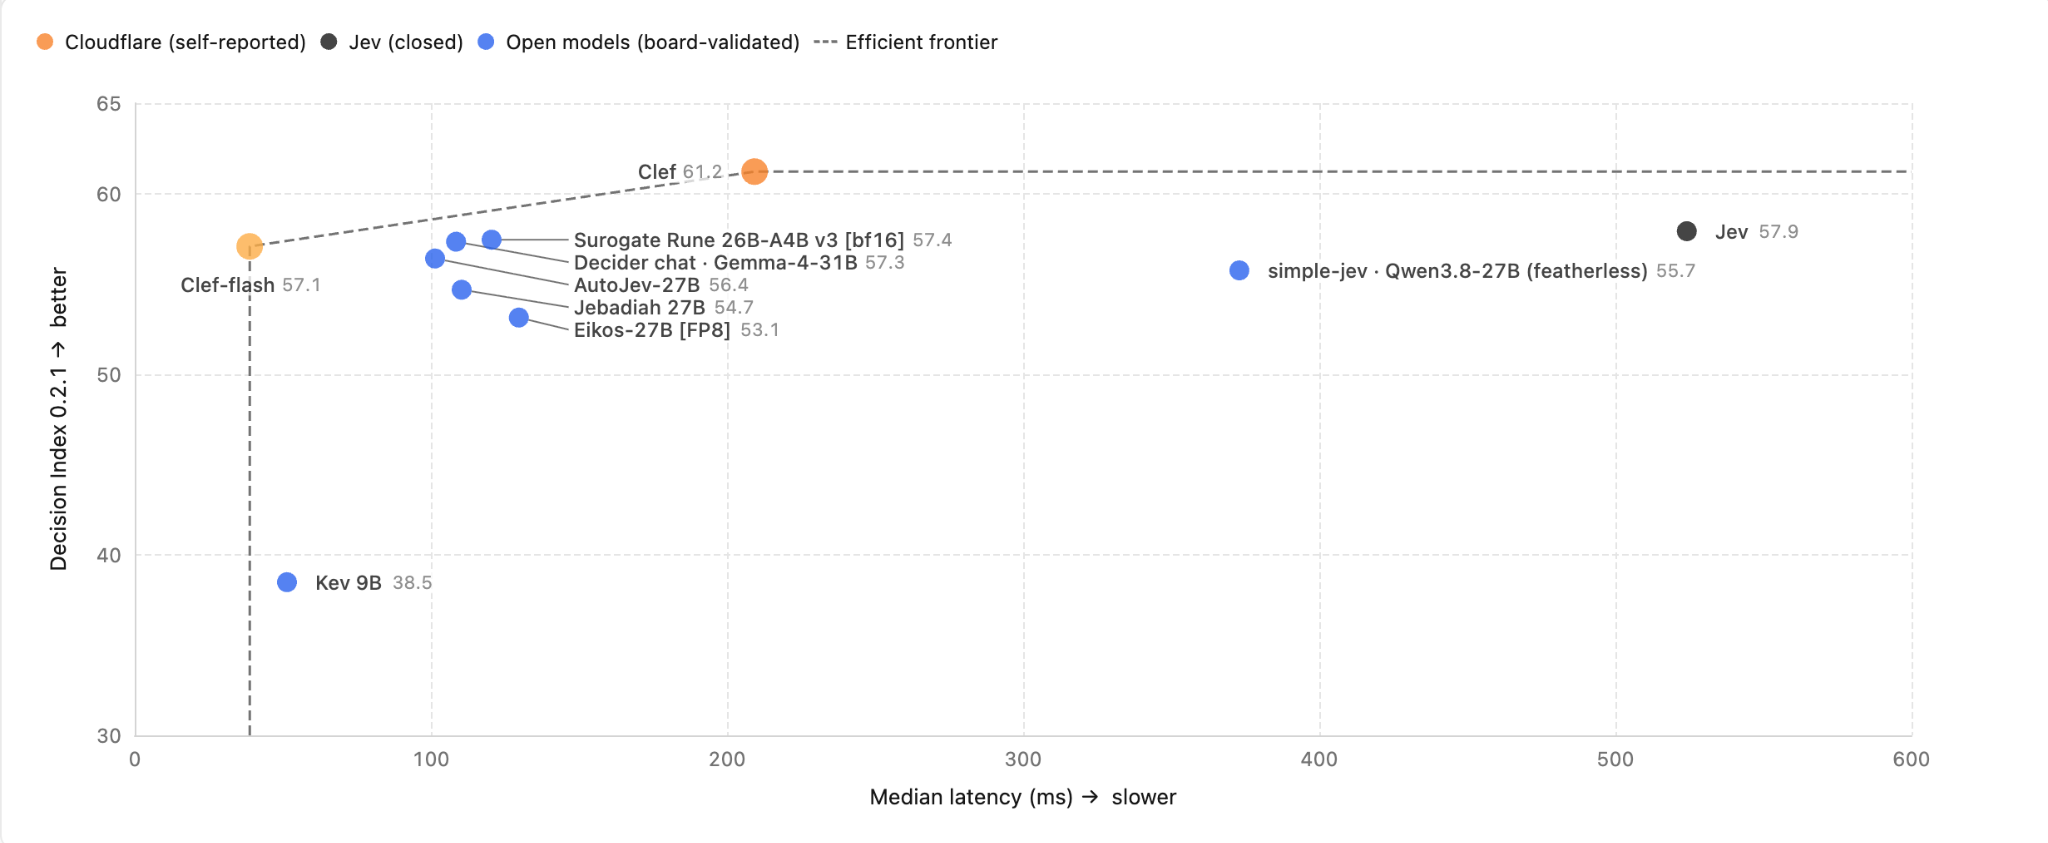
图源:Cloudflare 官方博客《Introducing Clef》(Cloudflare 自测)
- 不知道继续放大还会不会有持续的大幅提升。大语言模型从零点几 B 到几十 B、几百 B,再到几千 B,每一级都有可观的进步,这是 scaling law 能被广泛接受的基础。决策模型目前没有人公开推到百亿参数以上,也就没有证据说明它会有同样的长期收益。
而且,通用大模型的目标是 AGI,也就是无所不能的通用智能,越大越接近这个目标。决策模型从 Jev 走红开始就不是这个思路,它要的是在一个个边界清晰的小问题上又快又准,本来就不打算做无所不能的模型。
相比之下,数据规模的作用倒是很清楚。Base Labs 用同一个 9B 底座,把训练数据从 25.4 万条扩到 419 万条(约 16 倍),Jev Decision Index 公开集得分从 45.5 涨到 66.0(其间还换了一次注意力掩码,不全是数据的功劳);之后数据量只多了约 40%,主要靠审查、修复数据,并针对薄弱环节补充合成数据,又涨了约 7.9 分。他们自己的总结是:「训练前沿决策模型,靠的是数据、数据、数据。」
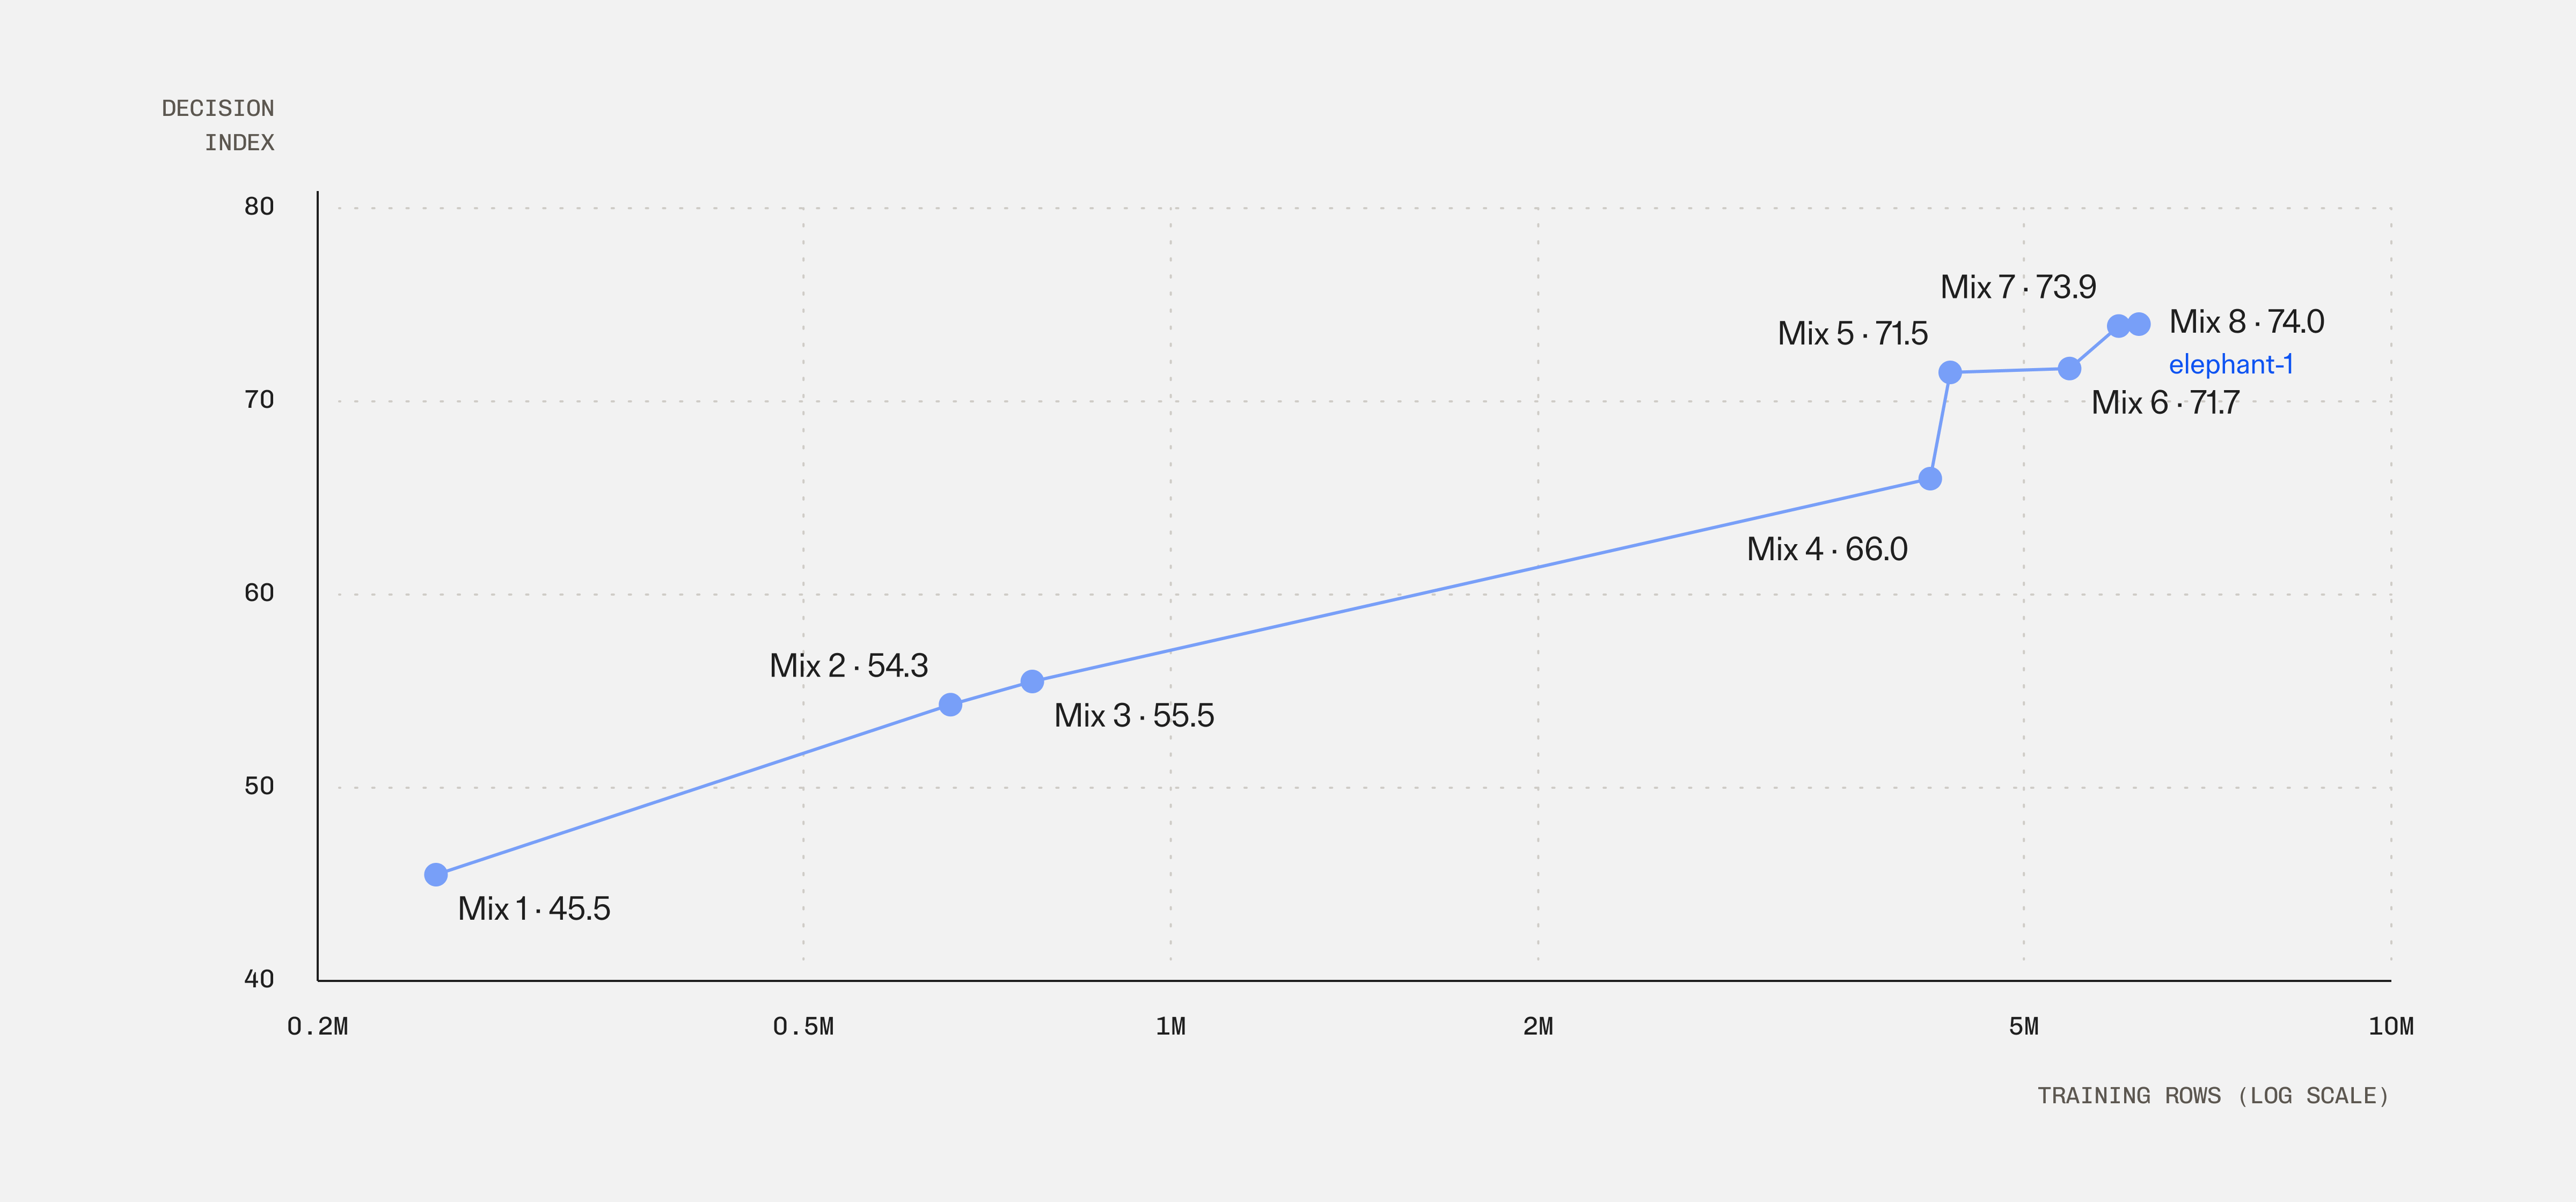
图源:Base Labs 官方技术报告《Mammoth-1 and Elephant-1》(自报)
所以我的判断是:决策模型的提升路径更可能是「领域数据 + 合适大小的模型」,而不是像大模型那样一路堆参数。这仍是一个没有定论的开放问题。
还有个小问题:决策模型一般不能加「思考」CoT。决策模型的场景和思路就是追求低延迟,一次前向直接出答案;加入推理步骤,就和它存在的理由矛盾了。也有厂商持不同看法,比如 Levanto Labs 的 Marco De Rossi 说,企业客户愿意多等几百毫秒换一个对的答案。但我认为这不是重点:真需要多想一会儿的问题,本来就该交给大模型。
七、它和 BERT 有什么区别?
常见的疑问是:这不就是 BERT 吗?我的看法是,原理上很像,但用法上差别很大。
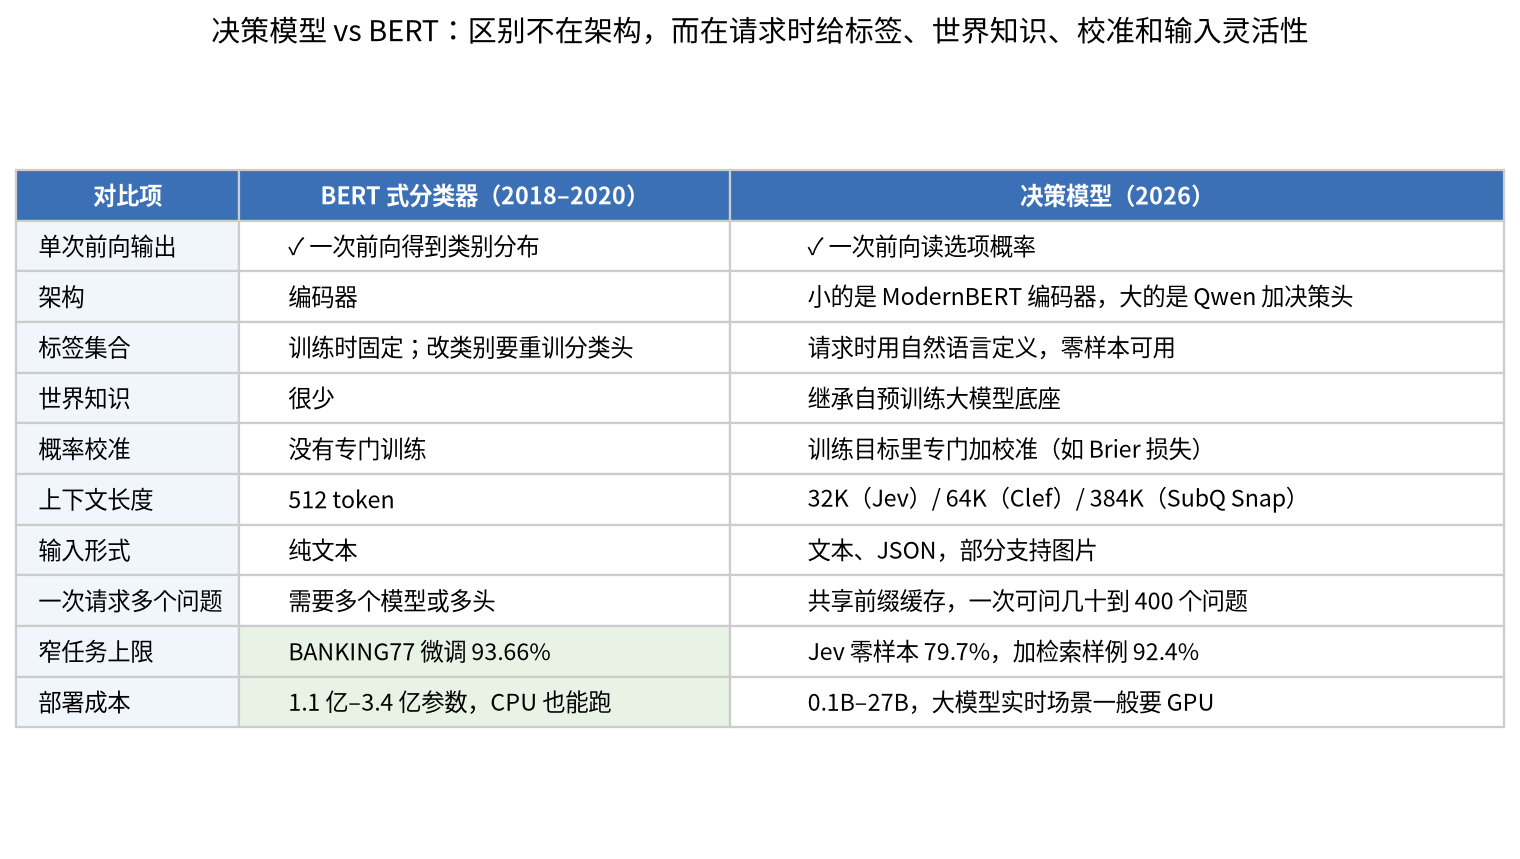
相似的地方比想象的还多。两者都是一次前向计算,输出类别的概率分布,不做文本生成。shipfrontier 整理 ggml-org 的决策模型合集时发现,最小的几款(0.1B 的 Julia-1、0.4B 的 Laya)本身就是 ModernBERT 编码器;llama.cpp 支持决策模型的 PR 里甚至直接说,决策模型本质上就是传统 embedding 模型外面包了一层。Base Labs 也把 Qwen 的部分注意力层改成了块内双向注意力,数据相同的情况下得分从 44.8 提到了 48.6,这一步本身就更接近 BERT。BANKING77 上 2020 年的微调 BERT(93.66%)到今天仍然超过 Jev 的零样本成绩,这也印证了前文的观点:在窄任务上,专门训练的模型很强。
所以区别不在架构。我认为真正的区别在三件事,再加上输入和处理能力的灵活性:
- 标签在请求时给,零样本可用。BERT 的分类头是按固定标签集训练的,加一个类别就要重新训练。决策模型的选项写在请求里,用自然语言描述,换问题、换选项都不用重新训练。
- 继承了大模型的世界知识。大的决策模型是从预训练大模型后训练出来的,懂常识、能读懂指令和选项说明;BERT 只认训练时见过的标签。
- 面向校准训练。主流决策模型在训练时专门加了校准目标(比如 Brier 损失),概率可以直接拿来设阈值。
- 上下文长得多。BERT 最多 512 个 token。Jev 是 32K,Clef 是 64K,SubQ Snap 做到了 384K,可以把整段对话、整份合同或一长串 Agent 执行记录放进去判断。
- 输入形式更丰富。OpenAI 的 Decisions API 支持文本、图片和原生 JSON,Clef 带视觉编码器,SubQ Snap 一次可以放 4 张图片;阿里的 Qwen-Audio-Jev 甚至直接输入音频(目前还在论文阶段)。
- 一次请求问多个问题。共享前缀缓存后,同一份输入上的多个问题几乎只多花后缀的计算量。
当然,代价是体量。BERT 只有 1.1 亿到 3.4 亿参数,CPU 也能跑;大一点的决策模型实时场景一般需要 GPU。
八、几个整活实验,和一个反面案例
决策模型火了之后,网上出现了不少整活实验,其中有玩笑,也有被拆穿的「神 demo」,各自说明了一些问题。
一枚硬币就能拿 50%。 10 月 14 日,Ethan Lambeth 在 X 上发帖「宣布」Coin Labs 的新决策模型 Flip-1:「蒸馏到 1 个参数」「在是/否基准上 50%」「完全离线运行」。实际内容就是一枚硬币。这条帖子有九千多赞,本身是个玩笑,并不是真实实验,但它点出了一个严肃问题:是否题的随机基线就是 50%,看决策模型的分数时,首先要看它比随机猜测好多少。
反面案例:Jev「通关」我的世界。 9 月 20 日,Ronak Malde 发帖称,Jev 加 GPT‑6 Astra 在《我的世界》里 8 分 43 秒打败了末影龙,总花费不到 1 美元,还说这种操作「只有靠 Jev 近乎即时的决策才做得到」。帖子很火,但很快被人拆穿了。LlamaFactory 作者 Yaowei Zheng 转述了 Feitian Shanke 的拆解:Jev 一共被调用 165 次,其中 129 次(78.2%)只有一个可选动作,等于代码已经替它选好了;路线和动作都是预设的模板;把 Jev 换成随机选择、连规划器也去掉(这套改动版用的是 Kimi K3,不是 Astra),照样能通关。CmsChase 在原帖下也指出,一半以上的决策只有一个选项,很多相邻决策的提示词只差一个方块,「没有 Jev 也能通关」。(Feitian Shanke 的原始拆解我没找到,这里引用的是 Zheng 的转述。)
需要说明的是,剩下 36 次真正有得选的决策是不是关键,Zheng 自己也说还不确定,要多跑几轮有 Jev 和没 Jev 的对照才知道。他对其他 Jev 游戏 demo(马里奥、地铁跑酷、大乱斗)也提了同样的问题;那个「我复刻了特斯拉 FSD」的 demo 里,候选路径和安全刹车都是代码做的,Jev 只是挑一条路径。
作为对比,《星际争霸 2》实验里,团队拿 Jev + Astra 打游戏里最难的内置 AI,并做了几组对照(团队自报):只用 Jev 是 0/10 胜,Astra 规划 + 随机动作也是 0/10,Astra 规划 + Jev 是 9/10。有了随机基线,才能说明 Jev 的选择确实起了作用,这正是我的世界 demo 缺的那一步。
因此,评估决策模型的 demo 时,应先回答两个问题:真正有不止一个选项的决策有多少?换成随机选择或简单规则,结果差多少?
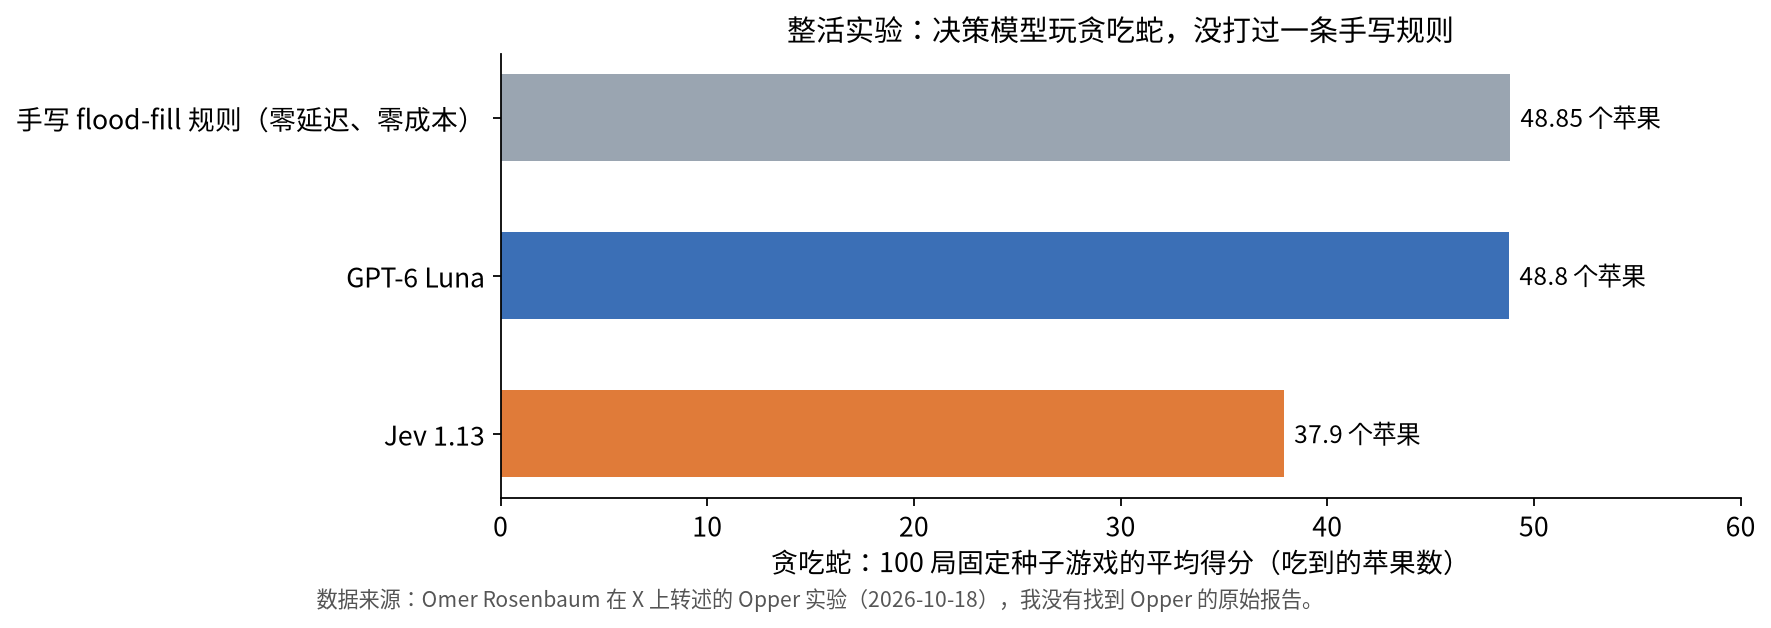
贪吃蛇输给了一条手写规则。 Omer Rosenbaum 转述了 Opper 的实验:让决策模型各玩 100 局固定种子的贪吃蛇,最好的 GPT‑6 Luna 平均吃到 48.8 个苹果,Jev 1.13 只有 37.9 个,而一条手写的 flood-fill 规则是 48.85 个,零延迟、零成本。他的结论是:决策模型上线前,先让它和「笨规则」比一比。
这几个实验放在一起,和本文的主线一致:决策模型适合做快速的小判断,但它不是万能的,能用规则或代码解决的问题就别交给模型;评估一个决策模型的效果,一定要拿随机基线和笨规则做对照。
参考资料
- TypeSafe:Introducing System One models & Jev
- 波恩大学,Deußer 等:Evaluating and Benchmarking the System One Model Jev(37 个数据集独立评测、校准、延迟和成本)
- UIUC,Zhu 等:JevAgentHarness(AgentDecision-4B,91.5% vs 82.0%,L4 上 31 ms vs Flash 809 ms)
- OpenAI:Build more responsive apps with the Decisions API(基于 GPT‑6 Luna,$0.10/百万 token,最多 400 个问题)
- Cloudflare:Introducing Clef: our open-source decision models(BANKING77 macro-F1、延迟中位数、64K 上下文,均为自测)
- Base Labs:Mammoth-1 and Elephant-1: frontier decision models(数据扩展实验、注意力掩码实验、Jev Decision Index 得分,自报)
- Fractional Research:Jev Tested: 2–5x Faster and 5–50x Cheaper(独立延迟、成本汇总,DistilBERT 88.0% vs Jev 76.4%)
- Saulius:Jev and RLCD(错误预算下的覆盖率,开源复刻 45%–57% vs Jev 约 70%)
- Braintrust:Evaling decision models for risk and harm classification
- Hamel Husain:How To Use Decision Models for Evals(调阈值、延迟与距离)
- shipfrontier:ggml-org 决策模型 GGUF 合集分析
- Josh Builds:Microsoft’s Decision Model Runs on Alibaba’s Qwen
- Overmind:Jev vs fine-tuned Qwen: what 8,556 decisions showed(X 原帖)
- Simon Smith:jev-banking77-experiment(Jev + 24 条检索样例 92.4%,BERT 93.66%)
- 掘金:1.5 秒的小模型给大模型当守门员(CPU 上 kev 4B 约 9 秒、0.8B 约 1.5 秒)
- Ollama:Ollama now supports Jev-style decision models
- Bespoke Labs:Nimble 仓库;daily.dev:Nimble 9B 独立实测
- Strands Agents:Introducing Strands Decider 2B;AWS Builder Center:Running Strands Decider 2B on AgentCore
- Subquadratic:Introducing SubQ Snap
- 阿里云百炼:decision-model-preview 模型信息;决策模型 API;QwenCloud 模型更新记录
- 阿里 Token Foundry:Qwen-Audio-Jev: A Unified Interface for Audio Decisions(v2,音频决策模型,自报)
- Unsloth:Train your own Decision Model with Unsloth
- 整活实验与反面案例:Flip-1 玩笑帖(Ethan Lambeth);Jev + Astra 通关我的世界原帖(Ronak Malde);我的世界 demo 拆解(Yaowei Zheng 转述 Feitian Shanke);CmsChase 的回复;星际争霸 2 随机对照实验(Mika,团队自报);贪吃蛇实验(Omer Rosenbaum 转述 Opper)
- Marco De Rossi(Levanto Labs):关于决策模型加推理的观点
- Casanueva 等(2020):Efficient Intent Detection with Dual Sentence Encoders(BANKING77 原论文)