
和大模型语音对话时,我们说出的话需要先被模型理解,模型的回答也要变成声音。早期语音助手通常把这些工作拆成语音识别、文本推理和语音合成几个步骤,而新一代模型开始直接处理音频,甚至能边听边说。
这篇文章从传统语音管线出发,看看音频如何进入大模型、模型如何生成声音,以及全双工实时对话是怎样实现的。
一、传统级联方案及其局限
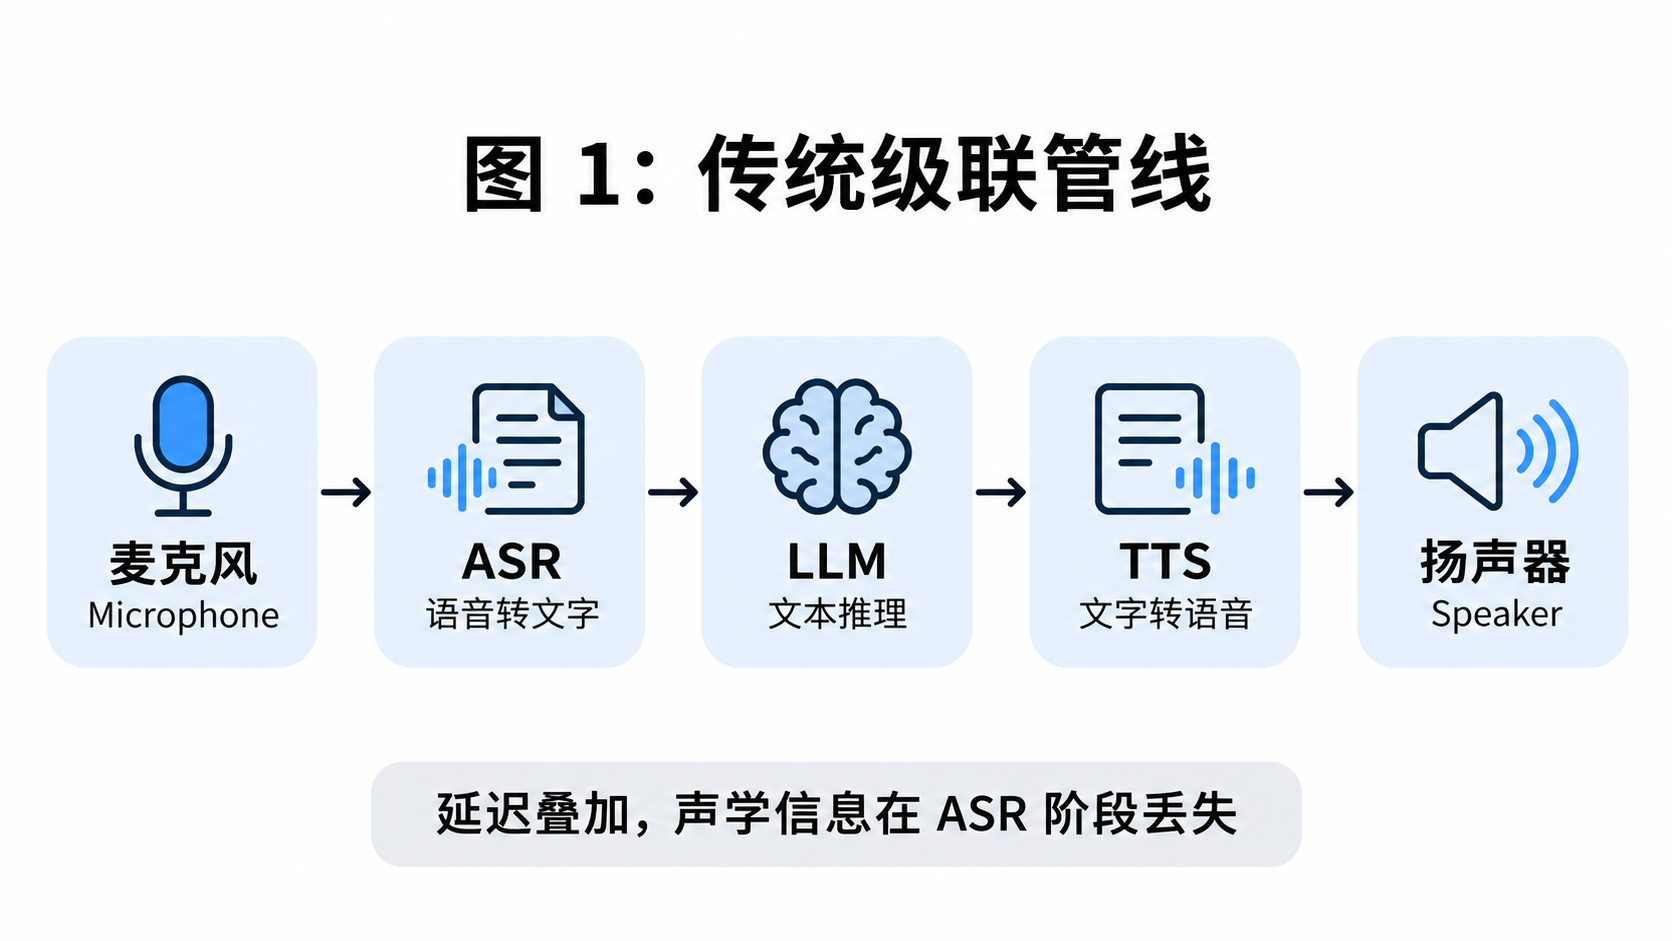
传统语音助手是级联的:麦克风 → ASR(语音转文字)→ LLM(文本推理)→ TTS(文字转语音)→ 扬声器。
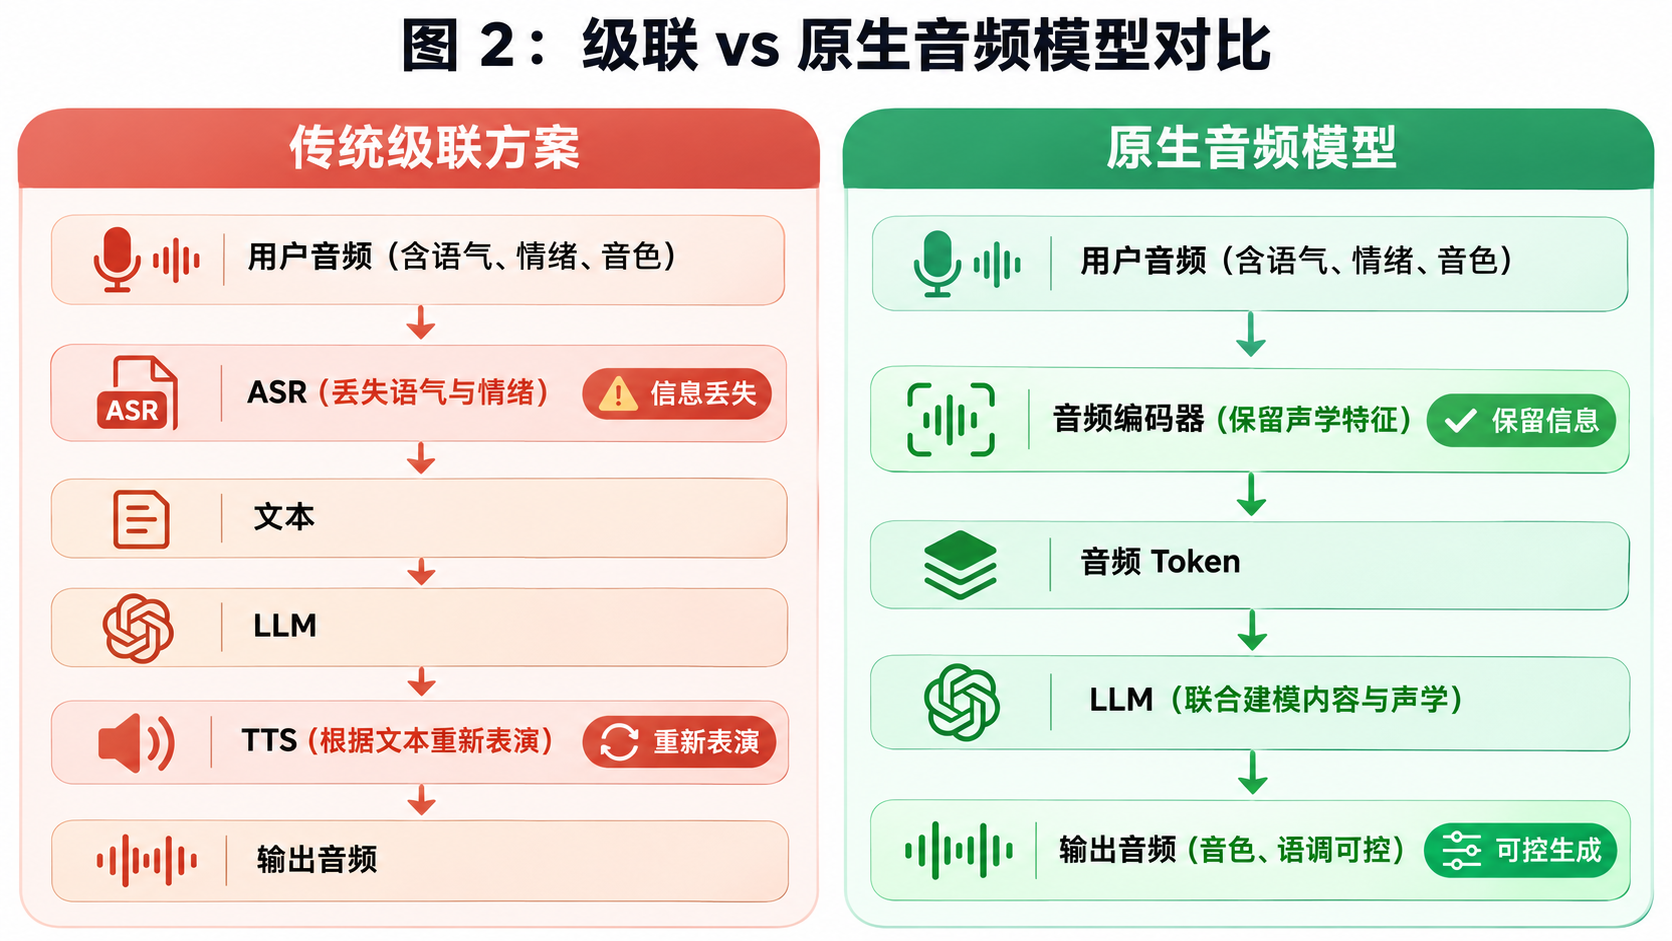
每一步都要等上一步完成,延迟叠加到 1 秒以上。更关键的是,语气、停顿、情绪、音色在 ASR 转文字时就丢了。一句生气的话和一句平静的话,转成文字后几乎一样。TTS 再怎么好,也只能根据文字“重新表演”,无法真正继承输入的声学特征。
传统 TTS 的位置与局限
独立 TTS(VITS、CosyVoice、Fish Speech、ElevenLabs 等)负责最后一步:把文字变成语音。它的优点是:
- 只需要文字输入时,延迟和成本更可控
- 音色库、情感标签、SSML 控制较成熟
- 很多产品仍用“强 LLM 文本 + 高质量 TTS”的组合
但它的根本局限在于:只负责“根据文本发声”,不负责“理解输入音频”。韵律和情绪是事后合成的,而不是从原始声学信号中继承的。新一代 TTS 本身也开始采用音频 token + 语言模型(如 VALL-E 类、CosyVoice 的自回归部分),但和全模态模型的技术正在收敛,核心区别仍在于是否原生处理输入音频。
二、核心接口:把连续波形变成离散 Token
无论输入还是输出,LLM 只吃离散 token。音频必须先被“tokenize”。
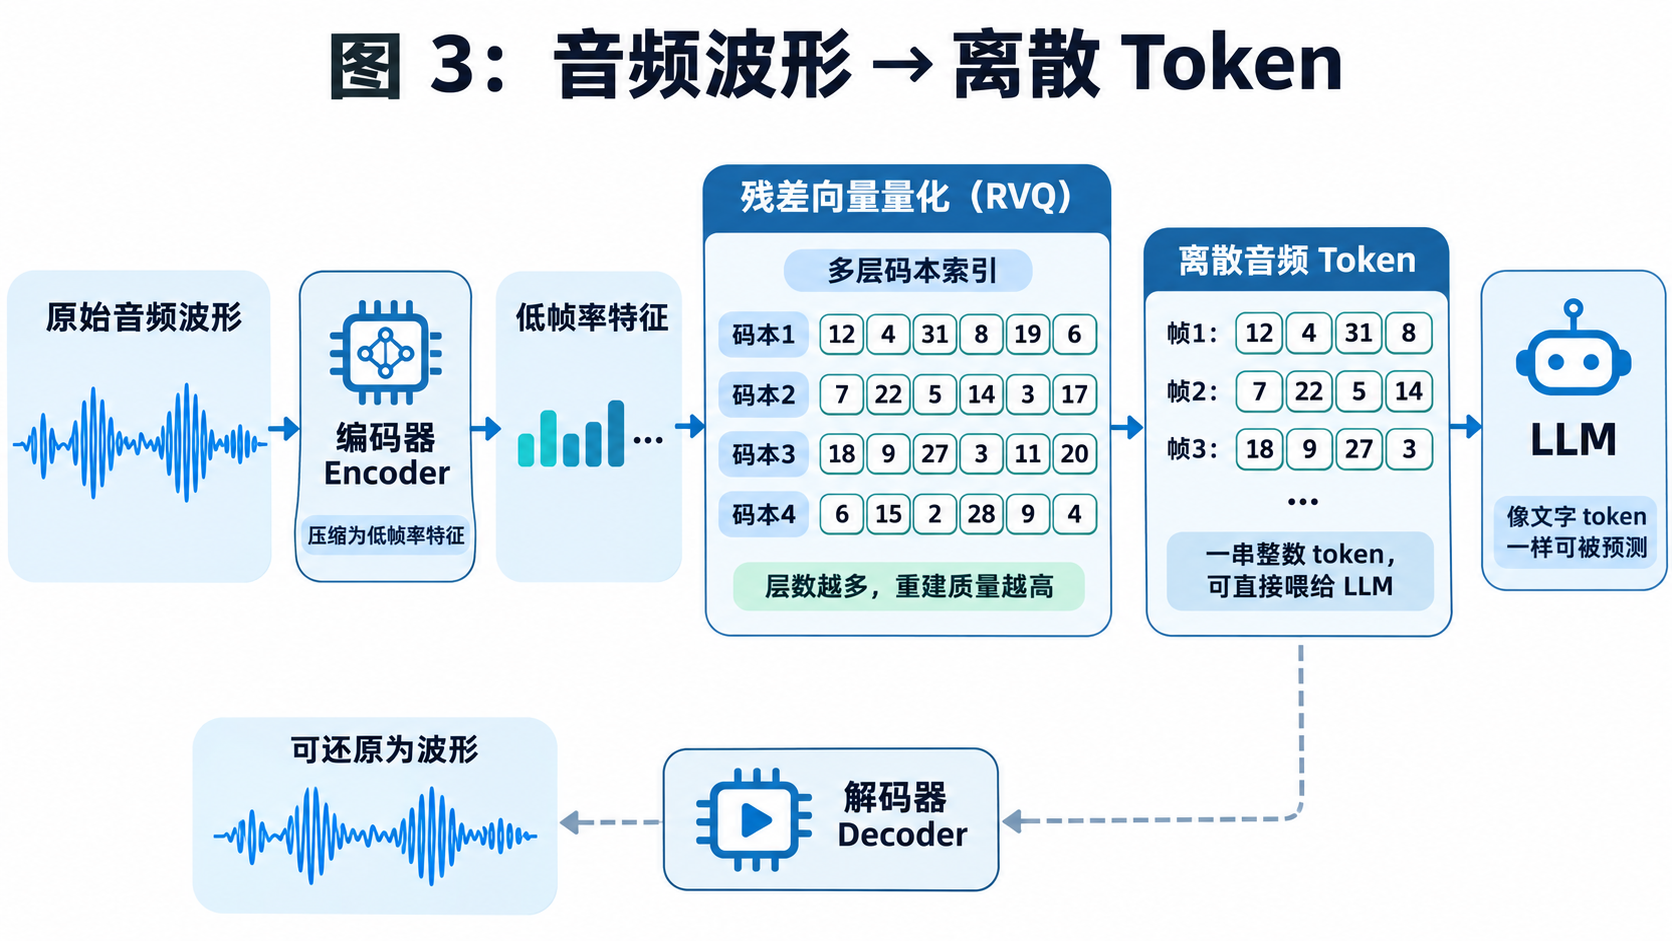
主流做法是神经音频编解码器(Neural Audio Codec),代表是 EnCodec、SoundStream、DAC、Mimi 等。流程是:
- 编码器把原始波形压缩成低帧率的连续特征(比如 12.5Hz 或 25Hz)。
- 用**残差向量量化(Residual Vector Quantization, RVQ)**把特征变成多层离散码本索引。
- 每一层量化上一层的残差,层数越多,重建质量越高。
结果是一串整数(例如每帧 8 个 token),LLM 可以直接预测这些整数,就像预测文字 token 一样。解码器再把 token 序列还原成波形。
这个“层数越多,重建质量越高”的过程和模拟信号转数字信号很像。音频波形是连续的模拟信号,RVQ 像是在做多比特量化:层数(码本)越多,相当于采样精度越高,量化误差越小,还原出来的波形就越接近原始信号。区别在于,这里量化的不是原始波形本身,而是编码器提取的特征,而且最终得到的是离散的码本索引,可以直接当成 token 序列处理。
有的 codec 还会分离语义 token(主要编码“说了什么”)和声学 token(编码音色、韵律、细节)。Moshi 的 Mimi codec 就做了这件事。这个接口同时服务于输入理解与输出生成。
三、音频输入:Omni 模型如何听懂
Omni 模型(GPT-4o、Qwen-Omni、LLaMA-Omni 等)的核心是把音频直接映射进 LLM 的 embedding 空间,实现原生音频输入。
常见结构:
- 语音编码器(常用 Whisper encoder,或原生 Audio Transformer)提取特征
- 一个可训练的 Adaptor/Projector 把特征投影到 LLM 的隐藏维度
- LLM 在统一的 token 流里处理文本、图像、音频
这个结构和图像输入的做法几乎一样。视觉模型(LLaVA、GPT-4V 等)也是:图像编码器(ViT)提取特征 → Projector 投影到 LLM 的 embedding 空间 → LLM 统一处理。音频输入只是把“图像 patch”换成了“音频帧/token”,把 ViT 换成了 Whisper encoder 或 Audio Transformer。两者都是“连续模态 → 编码器 → 离散/连续特征 → Projector → LLM embedding”的同一套路,区别只在于模态特性和时间序列特性。
不需要先转文本
原生音频输入的模型不需要先把语音转成文本再理解。音频编码器直接把波形变成特征,再投影进 LLM,模型是在声学表示上做推理的。语气、停顿、背景声、说话人特征可以保留一部分,而不像 ASR 那样只输出文字。
能不能理解音乐
能不能理解音乐,主要取决于训练数据和模型设计。如果训练时只见过大量语音对话数据,模型对音乐的理解会很有限(可能只能识别“这是音乐”或粗略风格);如果训练数据里包含音乐、环境声、混合音频,并且编码器本身有足够的容量,模型就可以在一定程度上理解旋律、节奏、乐器类型甚至音乐结构。当前大多数 Omni / Realtime 模型仍以语音对话为主,对音乐的支持程度因模型和训练数据而异,不是架构上的硬限制,而是数据与训练目标决定的。
四、音频输出:从 TTS 到原生生成
全双工 Live 模型:同时听和说
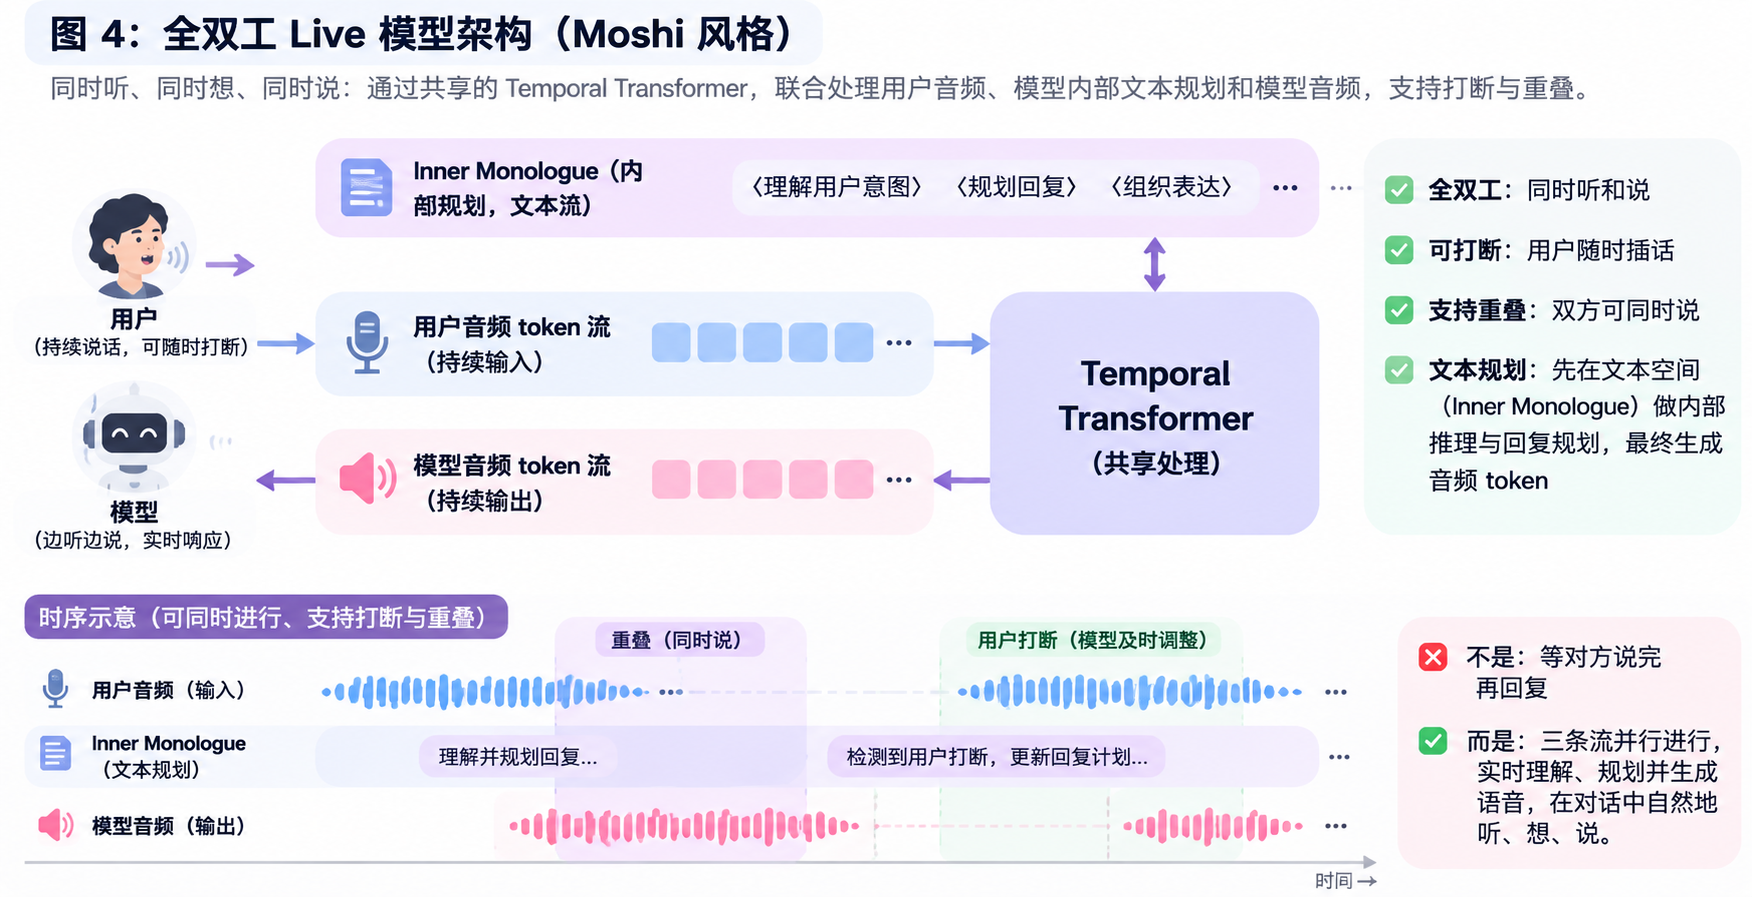
真正像人类对话的模型要解决全双工:自己说话的同时还能听对方说话,支持打断、重叠、自然轮替。代表是 Kyutai 的 Moshi(开源)、OpenAI 的 GPT-4o Realtime / GPT-Live、Gemini Live、Qwen-Omni Realtime 等。
关键架构思想(以 Moshi 为代表):
- 两条并行的音频流:用户音频 token + 模型自己的音频 token
- 一个共享的 Temporal Transformer 同时处理两条流
- 常配合一个 Inner Monologue(内部独白)文本流,让模型先在文本空间“想清楚”再发声
- 帧率通常 12.5Hz(每 80ms 一帧),理论延迟可低至 160ms 左右
Inner Monologue 与 CoT 的关系:这个机制和普通 LLM 的 Chain-of-Thought(CoT) 很像。普通 LLM 用 CoT 把推理过程显式写出来再给最终答案;Moshi 的 Inner Monologue 则是在音频生成之前,先在文本空间做一轮内部规划。区别在于,这里的“思考”必须和音频流实时对齐,并且最终要被解码成自然的语音,而不是只输出文字。
和普通 LLM 的差别在于时间步的组织方式。普通 LLM 是单一 token 流,每次推进一个 token。Moshi 这类模型把“时间”切成固定帧(比如 80ms 一帧),每一帧同时包含多条流的 token:用户音频 token、模型音频 token、以及 Inner Monologue 的文本 token。Temporal Transformer 按帧推进,在每一帧内把这些来自不同流的 token 一起处理(有的实现还会用更小的 Depth Transformer 处理同一帧内的多层声学 token)。所以看起来是“三条流并行”,本质上是把多条流的 token 对齐到同一时间步,由同一个 Transformer 在每一帧内联合建模。
音频是持续输入的。实际使用中,GPT-Live 和 Moshi 这类全双工模型是持续把音频流送进模型的,不是只在检测到说话时才输入。音频通道一直开着,静音或背景声也会被编码成 token(通常是“自然静音”类的 token)持续送入。模型自己决定怎么反应:继续听、发出 backchannel、开始说话、或者保持沉默。外部 VAD 不是必需的门控机制,打断和轮替是模型在每一帧里根据持续到来的用户音频 token 自己做的决策。
GPT-Live 的进一步创新:前后台分工
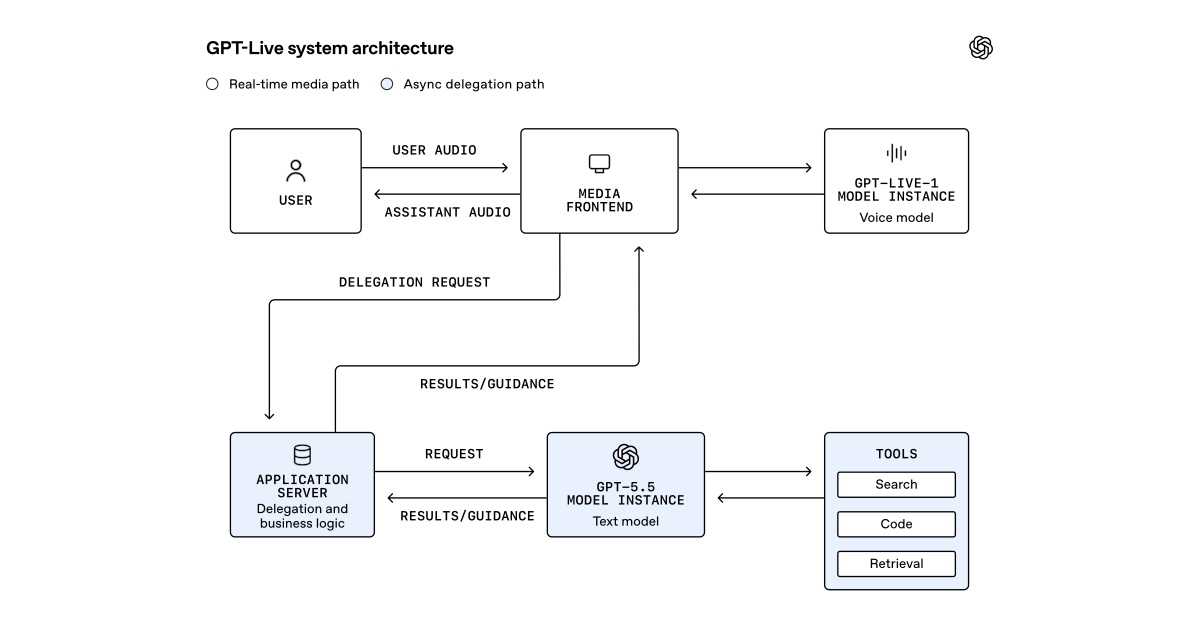
OpenAI 的 GPT-Live(2026 年发布)在全双工基础上做了更明确的拆分:
- 前台(语音层):一个专门的全双工语音模型(GPT-Live-1)。它持续处理用户音频和自己的输出音频,负责自然对话、打断、backchannel(“嗯”“对”这类反馈)、语速节奏等。这个模型本身不负责复杂推理。
- 后台(思考层):当问题需要搜索、深度推理、工具调用或多步任务时,前台模型会把任务**委托(delegate)**给一个更强的文本模型(发布时是 GPT-5.5,后来可接 GPT-6 Astra 等)。后台在计算的时候,前台继续说话、保持对话不中断,结果出来后再自然地接回来。
这样做的好处是把“说话”和“更深的思考”解耦。语音层可以保持低延迟和自然感,而智能水平可以随后台模型独立升级,不必每次都把整个语音模型重训一遍。用户侧可以选择推理强度(Instant / Medium / High),对应不同的后台配置。
为什么能控制音色和语调
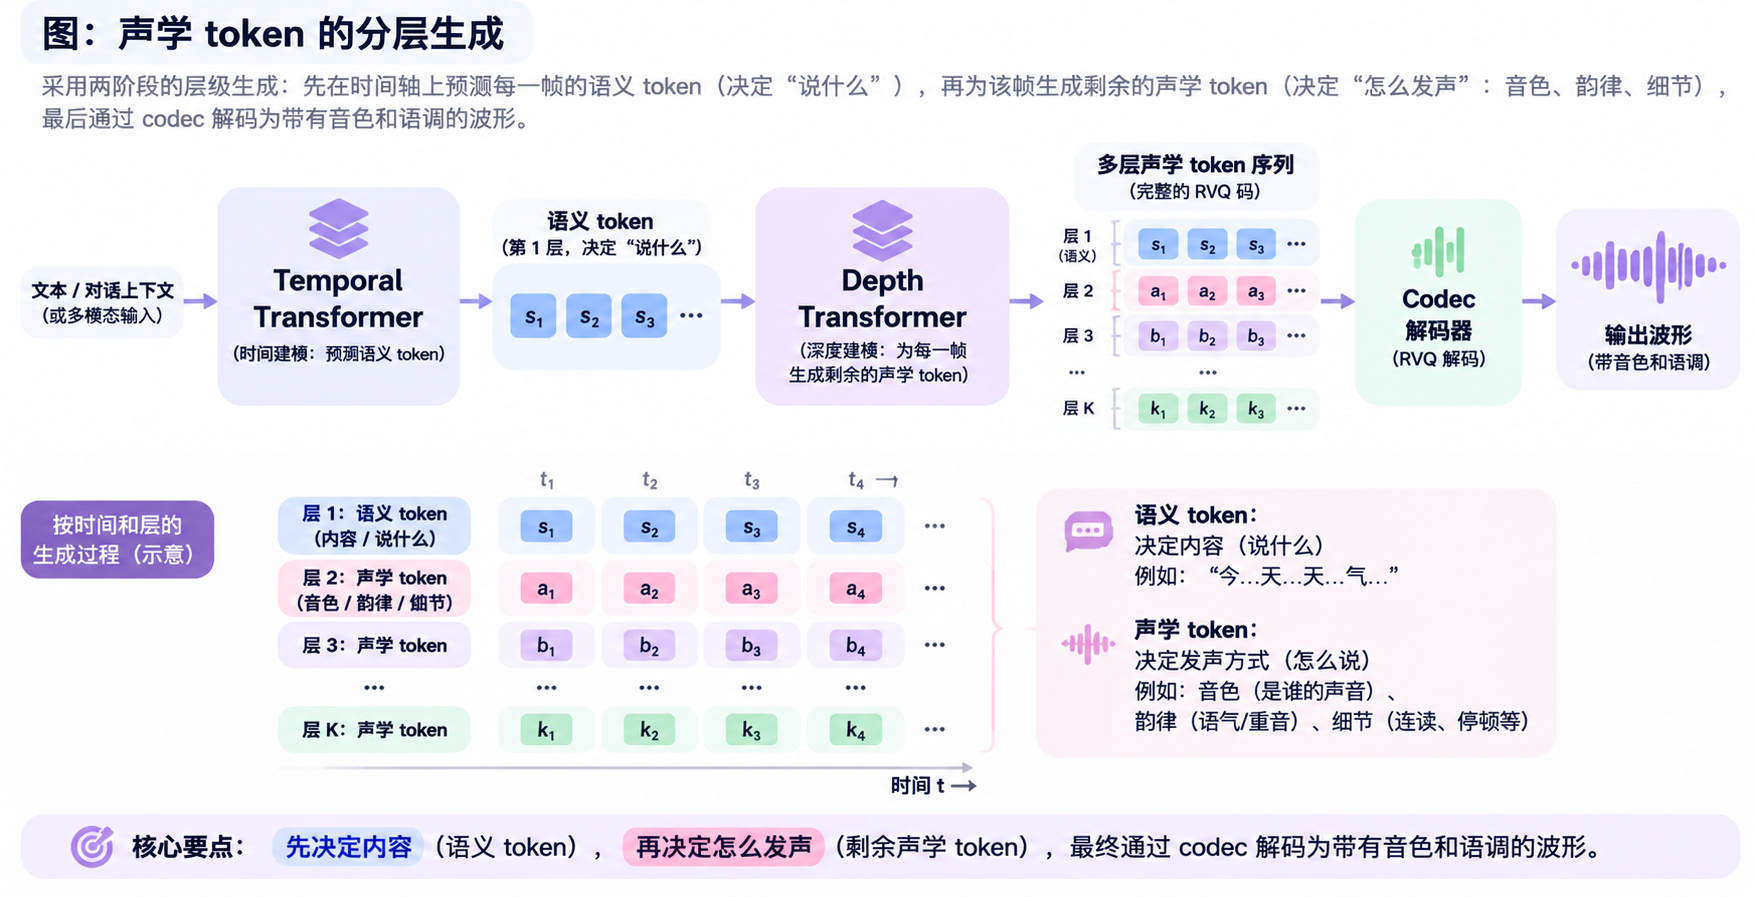
因为模型直接生成声学 token,而不是先生成文字再交给独立 TTS。声学 token 本身就编码了说话人身份(音色)、韵律(语调、节奏、强调)、情绪和风格、以及细节(呼吸、停顿、音质)。模型在训练时同时见过大量“内容 + 声学实现”的配对,所以它学会的是联合分布。生成时,内容决策和声学决策是耦合的,而不是事后合成。
具体怎么生成这些声学 token? 常见做法是分层生成。以 Moshi 为例:
- Temporal Transformer 在较低帧率(如 12.5Hz)上预测每一帧的语义 token(主要编码“说什么”)。
- 对每一帧,一个更小的 Depth Transformer 接着生成该帧剩余的声学 token(RVQ 后续层),这些 token 编码音色、韵律、细节。
- 最后把完整的多层 token 序列交给 codec 解码器,还原成波形。
这样做的好处是:语义决策和声学决策可以分开,但仍然在同一个模型里联合建模。模型先决定“这句话怎么说”,再决定“用什么样的声音、语调、节奏说出来”。生成过程本身就包含了音色和语调的控制,而不是事后交给独立 TTS 去合成。
从架构上看,这类有音频输出能力的全模态模型和普通 LLM 不同,通常不是单一 Transformer,而是由多个权重组成。以 Moshi 为例:主骨干是一个 Temporal Transformer(基于 Helium 7B),负责在时间轴上预测语义 token 和整体序列;每一帧内的多层声学 token 则由一个更小的 Depth Transformer 生成。两者是分开训练/联合微调的不同权重。普通 LLM 是一个 Transformer 从头到尾预测单一 token 流;这里则是“大模型负责时间与语义,小模型负责帧内声学细节”的分层结构。这样做可以控制计算量(声学 token 的生成不需要每次都跑完整的大模型),同时让语义和声学的建模各有侧重。
另外,很多模型支持用参考音频做条件(voice prompt / speaker embedding),实现零样本音色克隆或风格控制。传统 TTS 也能做,但原生音频模型把这个能力直接放进了同一个生成过程里。
五、总结
顺带一提,音乐生成模型(如 MusicGen、AudioGen、Jukebox 等)用的也是类似的套路:先用神经音频编解码器(如 EnCodec)把音乐波形转成离散 token,再让 Transformer 自回归预测这些 token,最后解码成音频。和语音对话模型的主要区别是训练数据和目标(音乐结构、旋律、节奏 vs 对话轮替),底层的“波形 → 离散 token → 自回归生成”是同一套接口。
- 输入侧:级联方案依赖 ASR 文本中间表示,丢失声学信息;Omni 模型通过编码器 + Projector 把音频原生接入 LLM,保留更多语气与特征。
- 输出侧:传统 TTS 只根据文本重新发声;原生模型直接生成声学 token,可控制音色、语调与情绪;全双工 Live 模型用并行流实现同时听和说。
- 进一步解耦:GPT-Live 把前台语音交互与后台深度思考拆开,让对话流畅度与智能水平可独立优化。
- 离散音频 token(尤其是 RVQ codec)是连接输入与输出的关键接口。
技术路线已经清晰:把音频变成 LLM 能直接预测的离散序列,再让同一个模型(或前后台分工的系统)同时处理输入和输出。剩下的是延迟、稳定性、多语言、工具调用和成本的工程问题。